Como dimensionar um servidor cloud para SaaS: CPU, RAM, NVMe
Para dimensionar um servidor cloud para uma aplicação SaaS, não parta do número de utilizadores. Comece pela memória de cada processo, depois a CPU de cada contentor, a seguir o disco para dados, WAL e backups, e confirme cada suposição com um teste de carga. Este guia faz isso num exemplo real: API e worker em Node.js, PostgreSQL, Redis e nginx em Docker Compose, testados numa só máquina. Os perfis abaixo são hipóteses de partida; para intervalos iniciais simples, veja o guia de dimensionamento.
A stack do exemplo
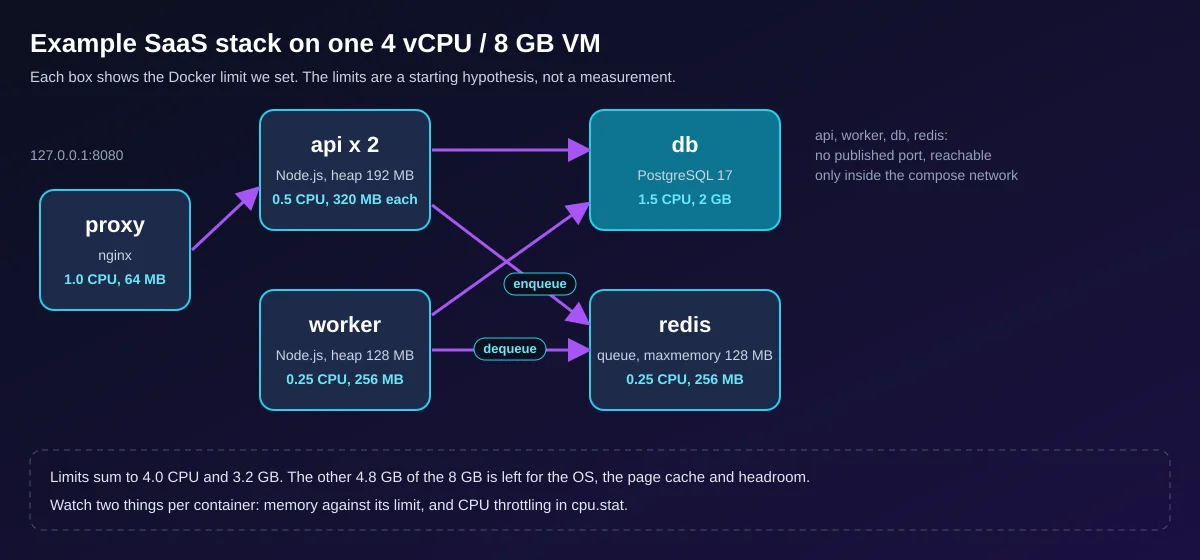
O exemplo é uma API de gestão de tarefas: um proxy nginx, duas réplicas da API em Node.js, um worker que esvazia uma fila Redis, PostgreSQL 17 e Redis 7. Só o proxy publica uma porta, e apenas em loopback. Os segredos ficam num ficheiro .env que não é enviado para o repositório, cada serviço tem um healthcheck e um limite de recursos, e os logs rodam. A monitorização aqui é docker stats, os contadores de cgroup e pg_stat_statements. Para a parte de Node.js em separado, veja Servidor Cloud para Node.js. Os ficheiros completos estão no fim.
Porque é que os utilizadores não se convertem em vCPU
- Concorrência, não número de pessoas - pedidos em curso = taxa de chegada x tempo por pedido (lei de Little). 1000 utilizadores que clicam uma vez por minuto são cerca de 17 pedidos por segundo; um script que consulta a cada segundo gera a mesma carga que 60 desses utilizadores.
- Custo do SQL e modelo de execução - na nossa execução a consulta do relatório demorou em média 1,07 ms em
pg_stat_statementse a da lista 0,07 ms, cerca de 15 vezes mais. Um processo Node.js usa aproximadamente um núcleo, por isso as vCPU da API correspondem ao número de processos, não de utilizadores. - Sockets, tarefas e picos - um WebSocket aberto retém memória durante toda a sua vida, uma tarefa em segundo plano disputa os mesmos núcleos com os pedidos, e dimensiona-se para a hora mais carregada, não para a média.
Três perfis de partida
Hipóteses, não medições. Os preços são valores mensais para Praga, recalculados com a tabela de preços em 2026-10-14.
| Perfil | Especificação inicial | Preço mensal, base |
|---|---|---|
| Dev / staging | 2 vCPU, 4 GB de RAM, 40 GB NVMe (Small) | EUR 15.00, 1 backup |
| Produção pequena | 4 vCPU, 8 GB de RAM, 80 GB NVMe (Medium), o exemplo tal como publicado | EUR 18.43, 1 backup |
| SaaS em crescimento, um servidor | 8 vCPU, 16 GB de RAM, 160 GB NVMe (Large) | EUR 36.88, 1 backup |
| SaaS em crescimento, separado | servidor de aplicação Medium mais um servidor de base de dados de 4 vCPU, 16 GB de RAM, 160 GB NVMe | EUR 18.43 (1 backup) + EUR 39.05 (3 backups) = EUR 57.48 |
A aritmética de memória, disco e backups
Os limites abaixo são os do ficheiro compose; a última coluna é a memória residente que o docker stats mostrou nos nossos degraus de carga, em todas as execuções.
| Contentor | Limite | Definição | Sob carga |
|---|---|---|---|
| proxy | 64 MB | nginx, um worker | 3-18 MB |
| api (x2) | 320 MB cada | --max-old-space-size=192, pool de 10 |
21-34 MB cada |
| worker | 256 MB | heap 128 MB, pool de 3 | 19-34 MB |
| db | 2 GB | shared_buffers 512 MB, work_mem 8 MB |
207-252 MB |
| redis | 256 MB | maxmemory 128 MB, sem remoção |
4-7 MB |
Os limites somam 3,2 GB, pelo que 4,8 GB dos 8 GB da VM ficam para o sistema operativo e a cache de páginas. Três regras geram os números. Primeira, shared_buffers começa em 25% da memória de um servidor de base de dados dedicado (documentação do PostgreSQL, verificada em 2026-10-14): 25% dos 2 GB do contentor são 512 MB. Segunda, work_mem aplica-se a cada operação de ordenação ou de hash, não a cada ligação, pelo que o total pode ser muitas vezes o valor definido: 23 ligações da aplicação a 8 MB com duas dessas operações cada dão um pior caso de 368 MB. Terceira, os pools multiplicados pelos processos (2 x 10 + 3 = 23) têm de ficar abaixo de max_connections (50).
Disco e backups. Com pouco mais de um milhão de linhas a base de dados tinha 146 MB, mas o diretório de dados 457 MB, dos quais 288 MB eram pg_wal: o WAL segue max_wal_size (um limite flexível), não o tamanho dos dados, por isso orce-o e deixe livre mais de 20% do disco. Neste conjunto de dados minúsculo, o pg_dump -Fc demorou 0,59 s (7 MB) e o restauro 1,78 s; o seu tempo de restauro é o seu tempo de indisponibilidade, por isso meça-o. Cada preço do DCXV Cloud inclui um backup semanal do disco: é uma cópia de segurança, não espaço para os seus ficheiros.
Encontre o gargalo com o k6
Fixe primeiro a condição de sucesso (aqui, p95 abaixo de 300 ms e menos de 1% de pedidos falhados), use um modelo aberto (constant-arrival-rate, veja a documentação do k6), aumente a taxa por degraus e acompanhe estes sinais em conjunto.
| Sinal | Comando | Mau sinal |
|---|---|---|
| p95, erros, iterações descartadas | resumo do k6 | p95 acima do objetivo, o servidor não acompanha a taxa de chegada |
| Throttling de CPU | grep nr_throttled /sys/fs/cgroup/cpu.stat no contentor |
cresce durante o degrau (documentação do kernel) |
| CPU steal | vmstat 5, coluna st |
acima de 0 numa VM: o anfitrião está saturado |
| Pressão de memória | docker stats, vmstat colunas si so |
perto do limite, ou com swap |
Medido numa máquina Linux arm64 de 12 núcleos com 14,4 GB de RAM, Docker 29.7.2, k6 2.3.0, PostgreSQL 17.11, Node.js 22.23.3, nginx 1.27.5, Redis 7.4.11, em 2026-10-14, uma execução de 40 s por degrau, salvo quando se mostram dois valores. Não é DCXV Cloud. O k6 partilhou as CPU com a stack, e o anfitrião usava também swap, por isso as latências são pessimistas: num teste real, execute o k6 a partir de uma segunda máquina. "Descartadas" conta as chegadas que o k6 ignorou porque os 500 utilizadores virtuais estavam ocupados.
| Config. do nginx | Pedidos/s oferecidos | Pedidos/s alcançados | p95 | Falhados | Descartadas |
|---|---|---|---|---|---|
| A, proxy 0,25 CPU | 1000 | 610 | 2,11 s | 0,03% | 15 595 |
| A, proxy 1,0 CPU | 1000 | 994 e 997 | 150 ms e 51,5 ms | 0% | 207 e 121 |
| A, proxy 1,0 CPU | 2000 | 941 | 1,77 s | 6,56% | 42 356 |
| B, keepalive | 1000 | 999 e 1000 | 2,66 ms e 2,42 ms | 0% | 36 e 0 |
| B, keepalive | 5000 | 4995 | 1,48 ms | 0% | 206 |
| B, keepalive | 8000 | 7918 | 23,1 ms | 0,02% | 2532 |
A lição é o método, não o débito. A config. A usava proxy_pass com uma variável e sem bloco upstream, pelo que o nginx abria uma nova ligação TCP à API em cada pedido. O proxy chegou primeiro ao limite de CPU (cpu.stat: 1512 dos 2787 períodos com throttling com 0,25 CPU, e com 1,0 CPU continuava a haver um teto perto de 940 pedidos/s) enquanto a base de dados usava bem menos de metade do seu limite. A config. B, um upstream com keepalive 32, manteve o proxy perto de um terço de uma CPU a 8000 pedidos/s. Os limites seguintes apareceram então nos mesmos contadores: a base de dados teve throttling em 301 dos 2790 períodos, e o worker de 0,25 CPU teve-o quase em todos os períodos e deixou 46 982 tarefas na fila (LLEN jobs). Um conjunto de dados de 146 MB cabe em memória, pelo que nada disto tocou no disco. Uma verificação com fio num ficheiro temporário (fio --name=w --filename=fio.tmp --size=256M --rw=write --bs=8k --fdatasync=1 --ioengine=sync --runtime=15 --time_based) mediu 700 escritas síncronas por segundo, com cerca de 1,4 ms; uma execução de leitura aleatória (fio --name=r --filename=fio.tmp --size=256M --rw=randread --bs=4k --iodepth=32 --ioengine=libaio --direct=1 --runtime=15 --time_based) indicou 399 000 IOPS, que é a cache de páginas e não o disco.
Calcule o preço do resultado no configurador
- Abra a página de servidores cloud. Ela não lê números deste artigo, por isso defina-os você: escolha a linha de plano mais próxima do seu perfil (Small, Medium ou Large) e ajuste depois os controlos de CPU (1-96), RAM (1-256 GB) e disco (20-960 GB) para os valores da sua folha de trabalho.
- Adicione backups, endereços IPv4 extra e horas de administração e leia o preço mensal completo, não o preço "a partir de". A administração gerida começa em EUR 30 por duas horas.
Verificado com a tabela de preços em 2026-10-14: o Medium com 3 backups custa EUR 21.47, e a mesma CPU com 16 GB de RAM EUR 29.95. A RAM é o que mais mexe no preço.
Configurar um servidor cloud para a sua aplicação
Quando separar a base de dados ou passar a dedicado
- Separe a BD quando precisar de mais de metade da memória da VM, quando a API e a BD entrarem em throttling mútuo na CPU ou quando quiser um ritmo próprio de restauro. Veja o guia de PostgreSQL.
- Passe a dedicado quando uma carga mantiver ocupadas mais de 70% de todas as vCPU no pico, precisar de mais do que as 96 vCPU ou 256 GB de RAM de um servidor cloud ou exigir latência de disco previsível. Veja os servidores dedicados.
Modelo de migração e reversão
Ensaie-o primeiro no servidor novo.
| Passo | Ação | Reversão |
|---|---|---|
| 1 | Restaure um dump recente no servidor novo, arranque a aplicação e submeta-a a um teste de carga | elimine o servidor novo |
| 2 | Congele as escritas, faça o dump final, restaure e compare o número de linhas | reabra as escritas no servidor antigo |
| 3 | Mude o DNS (TTL baixado para 300 s com um TTL antigo completo de antecedência) e teste o início de sessão, a encomenda, a tarefa e o correio | volte a pôr o DNS na origem |
| 4 | Mantenha o servidor antigo só de leitura pelo menos uma semana | reproduza as escritas novas no lado antigo |
Folha de dimensionamento
Imprima-a e preencha a coluna da direita com as suas próprias medições.
| Item | Como obter | O seu valor |
|---|---|---|
| Pedidos por segundo no pico | analítica ou teste de carga | |
| p95 alvo e taxa de falhas | o seu SLO, por exemplo 300 ms e 1% | |
| Processos da API | um por vCPU | |
| Limite de memória do contentor | RSS de pico sob carga mais margem | |
| Ligações à BD | pools x processos, abaixo de max_connections |
|
| Memória livre mantida | 20-25% da VM | |
| Disco | dados e crescimento + WAL + logs + imagens + dump temporário, e 20% livre | |
| Backups | quantos se mantêm, tempo de restauro medido | |
| Preço mensal | total do configurador com backups, IPv4, administração e data |
Reproduza
Precisa de Docker com Compose, curl, openssl e vmstat; a imagem do k6 é descarregada na primeira execução. Os ficheiros são os que executámos, com estas versões. As etiquetas postgres:17-alpine, redis:7-alpine e node:22-alpine mudam com novas versões e o npm install não tem ficheiro de bloqueio, por isso fixe etiquetas e versões se precisar do mesmo resultado.
compose.yaml
# "Small production" starting hypothesis for a 4 vCPU / 8 GB VM: limits sum to 4.0 CPU and 3.2 GB
name: saas-sizing

x-logging: &logging
  driver: json-file
  options: { max-size: 10m, max-file: "3" }   # logs cannot fill the disk

services:
  proxy:
    build: { context: ., dockerfile: Dockerfile.proxy }
    ports: ["127.0.0.1:8080:80"]        # the only published port, loopback only
    depends_on:
      api: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1/healthz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "1.0", memory: 64M } } }
    logging: *logging
    restart: unless-stopped

  api:
    build: .
    command: ["node", "--max-old-space-size=192", "src/api.js"]
    env_file: [.env]
    environment:
      PG_POOL: "10"
    expose: ["3000"]
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000/readyz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy:
      replicas: 2
      resources: { limits: { cpus: "0.5", memory: 320M } }
    logging: *logging
    restart: unless-stopped

  worker:
    build: .
    command: ["node", "--max-old-space-size=128", "src/worker.js"]
    env_file: [.env]
    environment:
      PG_POOL: "3"
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD-SHELL", "pgrep -f src/worker.js >/dev/null"]
      interval: 15s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

  db:
    image: postgres:17-alpine
    env_file: [.env]
    command: [postgres,
      -c, shared_buffers=512MB, -c, effective_cache_size=1536MB,
      -c, work_mem=8MB, -c, maintenance_work_mem=128MB,
      -c, max_connections=50, -c, max_wal_size=1GB,
      -c, shared_preload_libraries=pg_stat_statements,
      -c, log_min_duration_statement=250, -c, track_io_timing=on]
    volumes: ["pgdata:/var/lib/postgresql/data"]
    # no "ports": reachable only from the compose network
    shm_size: 256m
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $$POSTGRES_USER -d $$POSTGRES_DB"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "1.5", memory: 2G } } }
    logging: *logging
    restart: unless-stopped

  redis:
    image: redis:7-alpine
    env_file: [.env]
    command: ["sh", "-c", "exec redis-server --requirepass \"$$REDIS_PASSWORD\" --maxmemory 128mb --maxmemory-policy noeviction --appendonly yes"]
    volumes: ["redisdata:/data"]
    healthcheck:
      test: ["CMD-SHELL", "REDISCLI_AUTH=\"$$REDIS_PASSWORD\" redis-cli ping | grep -q PONG"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

volumes:
  pgdata:
  redisdata:
Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package.json ./
RUN npm install --omit=dev --no-audit --no-fund
COPY src ./src
USER node
Dockerfile.proxy
FROM nginx:1.27-alpine
COPY nginx.conf /etc/nginx/nginx.conf
nginx.conf
worker_processes 1;
events { worker_connections 1024; }
http {
  access_log off;
  # resolved once at start: restart the proxy if the api containers get new addresses
  upstream api {
    server api:3000;
    keepalive 32;   # reuse upstream connections instead of one TCP connect per request
  }
  server {
    listen 80;
    location = /healthz { return 200 "ok\n"; }
    location / {
      proxy_pass http://api;
      proxy_http_version 1.1;
      proxy_set_header Connection "";
      proxy_set_header Host $host;
      proxy_read_timeout 10s;
    }
  }
}
package.json
{
  "name": "saas-sizing-example",
  "private": true,
  "type": "module",
  "dependencies": {
    "ioredis": "5.4.1",
    "pg": "8.13.1"
  }
}
src/db.js
import pg from 'pg'
import Redis from 'ioredis'

// pool size x processes must stay under Postgres max_connections (see the budget table)
export const pool = new pg.Pool({
  connectionString: process.env.DATABASE_URL,
  max: Number(process.env.PG_POOL || 10),
  statement_timeout: 5000,
})
export const redis = new Redis(process.env.REDIS_URL, { maxRetriesPerRequest: 2 })
src/api.js
import http from 'node:http'
import { pool, redis } from './db.js'

const json = (res, code, body) => {
  res.writeHead(code, { 'content-type': 'application/json' })
  res.end(JSON.stringify(body))
}
const readBody = req => new Promise((ok, fail) => {
  let s = ''
  req.on('data', c => { s += c; if (s.length > 4096) req.destroy() })
  req.on('end', () => ok(s))
  req.on('error', fail)
})

const routes = {
  'GET /healthz': (req, res) => json(res, 200, { ok: true }),
  // readiness touches both stores; the container healthcheck uses it
  'GET /readyz': async (req, res) => {
    await pool.query('select 1')
    await redis.ping()
    json(res, 200, { ok: true })
  },
  'GET /api/tasks': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select id, title, status from tasks where account_id = $1 order by id desc limit 20', [account])
    json(res, 200, rows)
  },
  'GET /api/report': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select status, count(*)::int as n from tasks where account_id = $1 group by status', [account])
    json(res, 200, rows)
  },
  'POST /api/tasks': async (req, res) => {
    let b
    try { b = JSON.parse(await readBody(req)) } catch { return json(res, 400, { error: 'json' }) }
    const account = Number(b.account)
    if (!Number.isInteger(account) || account < 1 || typeof b.title !== 'string' || b.title.length > 200) {
      return json(res, 400, { error: 'input' })
    }
    const { rows } = await pool.query(
      "insert into tasks (account_id, title) values ($1, $2) returning id", [account, b.title])
    await redis.lpush('jobs', String(rows[0].id))
    json(res, 201, { id: rows[0].id })
  },
}

const server = http.createServer(async (req, res) => {
  const url = new URL(req.url, 'http://x')
  const h = routes[`${req.method} ${url.pathname}`]
  if (!h) return json(res, 404, { error: 'not found' })
  try { await h(req, res, url) } catch (e) {
    console.error(e.message)
    json(res, 503, { error: 'unavailable' })
  }
})
server.listen(3000, () => console.log('api up'))

// compose sends SIGTERM on stop: finish in-flight requests, then close the stores
process.on('SIGTERM', () => server.close(async () => { await pool.end(); redis.disconnect(); process.exit(0) }))
src/worker.js
import { createHash } from 'node:crypto'
import { pool, redis } from './db.js'

let stop = false
process.on('SIGTERM', () => { stop = true })

// stands in for real background work (mail, PDF, webhook): a little CPU, then one UPDATE
const work = title => {
  let h = title
  for (let i = 0; i < 2000; i++) h = createHash('sha256').update(h).digest('hex')
  return h.slice(0, 16)
}

console.log('worker up')
while (!stop) {
  const r = await redis.brpop('jobs', 2)
  if (!r) continue
  const id = Number(r[1])
  const { rows } = await pool.query('select title from tasks where id = $1', [id])
  if (!rows.length) continue
  await pool.query("update tasks set status = 'done', result = $2 where id = $1", [id, work(rows[0].title)])
}
await pool.end()
redis.disconnect()
init.sql
create extension if not exists pg_stat_statements;
create table tasks (
  id bigserial primary key,
  account_id int not null,
  title text not null,
  status text not null default 'open',
  result text,
  created_at timestamptz not null default now()
);
create index tasks_account_id_idx on tasks (account_id, id desc);
seed.sql
-- 1,000,000 tasks for 2,000 accounts (about 500 each), 70% done
insert into tasks (account_id, title, status)
select 1 + (g % 2000), 'task ' || g, case when g % 10 < 7 then 'done' else 'open' end
from generate_series(1, 1000000) g;
analyze tasks;
make-env.sh
#!/bin/sh
# writes .env with random secrets; never commit it, and never reuse these values elsewhere
set -eu
[ -e .env ] && { echo ".env exists, not overwriting"; exit 1; }
PG=$(openssl rand -hex 24)
RD=$(openssl rand -hex 24)
umask 077
cat > .env <<EOF
POSTGRES_USER=app
POSTGRES_PASSWORD=$PG
POSTGRES_DB=app
REDIS_PASSWORD=$RD
DATABASE_URL=postgres://app:$PG@db:5432/app
REDIS_URL=redis://:$RD@redis:6379
EOF
k6.js
import http from 'k6/http'
import { check } from 'k6'

const BASE = __ENV.BASE || 'http://proxy'
const RATE = Number(__ENV.RATE || 100)

// open model: requests arrive at RATE per second whether or not the server keeps up,
// which is how real users behave (closed-loop VUs hide overload)
export const options = {
  scenarios: {
    mixed: {
      executor: 'constant-arrival-rate',
      rate: RATE,
      timeUnit: '1s',
      duration: __ENV.DURATION || '30s',
      preAllocatedVUs: 50,
      maxVUs: 500,
    },
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
  },
  summaryTrendStats: ['avg', 'med', 'p(90)', 'p(95)', 'p(99)', 'max'],
}

export default function () {
  const account = 1 + Math.floor(Math.random() * 2000)
  const r = Math.random()
  let res
  if (r < 0.80) res = http.get(`${BASE}/api/tasks?account=${account}`)
  else if (r < 0.90) res = http.get(`${BASE}/api/report?account=${account}`)
  else res = http.post(`${BASE}/api/tasks`, JSON.stringify({ account, title: 'k6 task' }),
    { headers: { 'content-type': 'application/json' } })
  check(res, { 'status 200/201': x => x.status === 200 || x.status === 201 })
}
bench.sh
#!/bin/sh
# usage: ./bench.sh 200 500 1000   (requests per second, one 40 s step each)
set -eu
NET=$(docker compose ps -q proxy | xargs docker inspect --format '{{range $k, $v := .NetworkSettings.Networks}}{{$k}}{{end}}')
for RATE in "$@"; do
  echo "=== ${RATE} req/s"
  # mid-run snapshot of container CPU / memory and host CPU steal ("st") and swap ("si so")
  ( sleep 20; docker stats --no-stream --format '{{.Name}} cpu={{.CPUPerc}} mem={{.MemUsage}}' $(docker compose ps -q); vmstat 5 2 | tail -1 ) &
  docker run --rm -i --network "$NET" -e RATE="$RATE" -e DURATION=40s \
    grafana/k6 run --quiet - < k6.js 2>&1 | grep -E 'http_req_duration\.|http_req_failed\.|http_reqs|dropped_iterations|vus_max'
  wait
done
sh make-env.sh
docker compose up -d --build
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < init.sql
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < seed.sql
curl -s http://127.0.0.1:8080/readyz
./bench.sh 500 1000
docker compose down -v
Os seus números serão diferentes. Quando forem, confie neles e não nos nossos, e depois configure um servidor cloud para a sua aplicação ou escreva para sales@dcxv.com.