Dimensionner un serveur cloud pour un SaaS : CPU, RAM, NVMe
Pour dimensionner un serveur cloud pour une application SaaS, ne partez pas du nombre d'utilisateurs. Commencez par la mémoire de chaque processus, puis la CPU de chaque conteneur, ensuite le disque pour les données, le WAL et les sauvegardes, et vérifiez chaque hypothèse par un test de charge. Ce guide le fait sur un exemple réel : API et worker Node.js, PostgreSQL, Redis et nginx sous Docker Compose, testés sur une seule machine. Les profils ci-dessous sont des hypothèses de départ ; pour des plages de départ simples, voir le guide de dimensionnement.
La pile de l'exemple
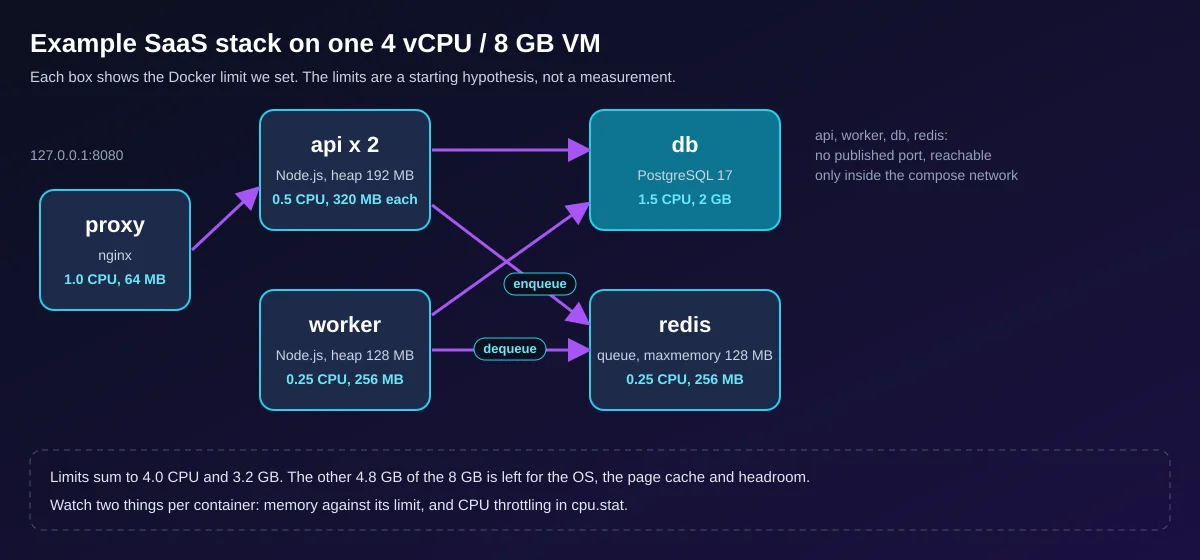
L'exemple est une API de suivi de tâches : un proxy nginx, deux réplicas de l'API Node.js, un worker qui vide une file Redis, PostgreSQL 17 et Redis 7. Seul le proxy publie un port, et uniquement sur loopback. Les secrets sont dans un fichier .env non commité, chaque service a un healthcheck et une limite de ressources, et les logs tournent. La supervision, ici, c'est docker stats, les compteurs cgroup et pg_stat_statements. Pour le côté Node.js seul, voir Serveur Cloud pour Node.js. Les fichiers complets figurent à la fin.
Pourquoi les utilisateurs ne se convertissent pas en vCPU
- Concurrence, pas effectif - requêtes en cours = taux d'arrivée x durée par requête (loi de Little). 1000 utilisateurs qui cliquent une fois par minute représentent environ 17 requêtes par seconde ; un script qui interroge chaque seconde produit la même charge que 60 de ces utilisateurs.
- Coût du SQL et modèle d'exécution - dans notre essai, la requête de rapport a pris en moyenne 1,07 ms dans
pg_stat_statementset la requête de liste 0,07 ms, soit environ 15 fois plus. Un processus Node.js utilise environ un cœur, donc les vCPU de l'API correspondent au nombre de processus, pas d'utilisateurs. - Sockets, tâches et pics - un WebSocket ouvert garde de la mémoire pendant toute sa vie, une tâche de fond se dispute les mêmes cœurs que les requêtes, et l'on dimensionne pour l'heure la plus chargée, pas pour la moyenne.
Trois profils de départ
Des hypothèses, pas des mesures. Les prix sont des montants mensuels pour Prague, recalculés d'après la grille tarifaire le 2026-10-14.
| Profil | Spécification de départ | Prix mensuel, base |
|---|---|---|
| Dev / staging | 2 vCPU, 4 Go de RAM, 40 Go NVMe (Small) | EUR 15.00, 1 sauvegarde |
| Petite production | 4 vCPU, 8 Go de RAM, 80 Go NVMe (Medium), l'exemple tel que publié | EUR 18.43, 1 sauvegarde |
| SaaS en croissance, un serveur | 8 vCPU, 16 Go de RAM, 160 Go NVMe (Large) | EUR 36.88, 1 sauvegarde |
| SaaS en croissance, séparé | serveur d'application Medium plus serveur de base de données de 4 vCPU, 16 Go de RAM, 160 Go NVMe | EUR 18.43 (1 sauvegarde) + EUR 39.05 (3 sauvegardes) = EUR 57.48 |
L'arithmétique de la mémoire, du disque et des sauvegardes
Les limites ci-dessous sont celles du fichier compose ; la dernière colonne indique la mémoire résidente affichée par docker stats pendant nos paliers de charge, tous essais confondus.
| Conteneur | Limite | Réglage | Sous charge |
|---|---|---|---|
| proxy | 64 Mo | nginx, un worker | 3-18 Mo |
| api (x2) | 320 Mo chacun | --max-old-space-size=192, pool de 10 |
21-34 Mo chacun |
| worker | 256 Mo | tas 128 Mo, pool de 3 | 19-34 Mo |
| db | 2 Go | shared_buffers 512 Mo, work_mem 8 Mo |
207-252 Mo |
| redis | 256 Mo | maxmemory 128 Mo, sans éviction |
4-7 Mo |
Les limites totalisent 3,2 Go, ce qui laisse 4,8 Go sur les 8 Go de la VM pour le système et le cache de pages. Trois règles produisent ces chiffres. Première règle, shared_buffers démarre à 25% de la mémoire d'un serveur de base de données dédié (documentation PostgreSQL, vérifiée le 2026-10-14) : 25% des 2 Go du conteneur font 512 Mo. Deuxième règle, work_mem s'applique par opération de tri ou de hachage, pas par connexion, donc le total peut valoir plusieurs fois la valeur réglée : 23 connexions applicatives à 8 Mo avec deux opérations de ce type chacune donnent un pire cas de 368 Mo. Troisième règle, les pools multipliés par les processus (2 x 10 + 3 = 23) doivent rester sous max_connections (50).
Disque et sauvegardes. Après environ 1,04 million de lignes, la base faisait 146 Mo mais le répertoire de données 457 Mo, dont 288 Mo pour pg_wal : le WAL suit max_wal_size (une limite souple), pas la taille des données, donc budgétez-le et gardez plus de 20% du disque libre. Sur ce jeu de données minuscule, pg_dump -Fc a pris 0,59 s (7 Mo) et la restauration 1,78 s ; votre temps de restauration est votre durée d'indisponibilité, mesurez-le. Chaque prix DCXV Cloud inclut une sauvegarde hebdomadaire du disque : une copie de sécurité, pas de la place pour vos fichiers.
Trouver le goulot d'étranglement avec k6
Fixez d'abord la condition de réussite (ici, p95 sous 300 ms et moins de 1% de requêtes en échec), utilisez un modèle ouvert (constant-arrival-rate, voir la documentation k6), augmentez le débit par paliers et surveillez ensemble ces signaux.
| Signal | Commande | Mauvais signe |
|---|---|---|
| p95, erreurs, itérations abandonnées | résumé k6 | p95 au-dessus de la cible, le serveur ne suit pas le taux d'arrivée |
| Throttling CPU | grep nr_throttled /sys/fs/cgroup/cpu.stat dans le conteneur |
augmente pendant le palier (documentation du noyau) |
| CPU steal | vmstat 5, colonne st |
au-dessus de 0 sur une VM : l'hôte est saturé |
| Pression mémoire | docker stats, vmstat colonnes si so |
près de la limite, ou swap |
Mesuré sur une machine Linux arm64 à 12 cœurs avec 14,4 Go de RAM, Docker 29.7.2, k6 2.3.0, PostgreSQL 17.11, Node.js 22.23.3, nginx 1.27.5, Redis 7.4.11, le 2026-10-14, un essai de 40 s par palier sauf mention de deux valeurs. Ce n'est pas DCXV Cloud. k6 partageait les CPU avec la pile, et l'hôte utilisait aussi du swap : les latences sont donc pessimistes, et pour un vrai test il faut lancer k6 depuis une seconde machine. "Abandonnées" compte les arrivées que k6 a ignorées parce que les 500 utilisateurs virtuels étaient occupés.
| Config nginx | Req./s proposées | Req./s atteintes | p95 | Échecs | Abandonnées |
|---|---|---|---|---|---|
| A, proxy 0,25 CPU | 1000 | 610 | 2,11 s | 0,03% | 15 595 |
| A, proxy 1,0 CPU | 1000 | 994 et 997 | 150 ms et 51,5 ms | 0% | 207 et 121 |
| A, proxy 1,0 CPU | 2000 | 941 | 1,77 s | 6,56% | 42 356 |
| B, keepalive | 1000 | 999 et 1000 | 2,66 ms et 2,42 ms | 0% | 36 et 0 |
| B, keepalive | 5000 | 4995 | 1,48 ms | 0% | 206 |
| B, keepalive | 8000 | 7918 | 23,1 ms | 0,02% | 2532 |
La leçon est la méthode, pas le débit. La config A utilisait proxy_pass avec une variable et sans bloc upstream, si bien que nginx ouvrait une nouvelle connexion TCP vers l'API à chaque requête. Le proxy a atteint sa limite de CPU en premier (cpu.stat : 1512 des 2787 périodes bridées à 0,25 CPU, et à 1,0 CPU un plafond restait proche de 940 req./s) alors que la base utilisait bien moins de la moitié de sa limite. La config B, un upstream avec keepalive 32, a maintenu le proxy autour d'un tiers de CPU à 8000 req./s. Les limites suivantes sont ensuite apparues dans les mêmes compteurs : la base a été bridée sur 301 des 2790 périodes, et le worker à 0,25 CPU l'a été presque à chaque période en laissant 46 982 tâches dans la file (LLEN jobs). Un jeu de données de 146 Mo tient en mémoire, donc rien de tout cela n'a sollicité le disque. Un contrôle fio sur un fichier temporaire (fio --name=w --filename=fio.tmp --size=256M --rw=write --bs=8k --fdatasync=1 --ioengine=sync --runtime=15 --time_based) a mesuré 700 écritures synchrones par seconde, d'environ 1,4 ms ; un essai de lecture aléatoire (fio --name=r --filename=fio.tmp --size=256M --rw=randread --bs=4k --iodepth=32 --ioengine=libaio --direct=1 --runtime=15 --time_based) a annoncé 399 000 IOPS, ce qui est le cache de pages et non le disque.
Chiffrer le résultat dans le configurateur
- Ouvrez la page des serveurs cloud. Elle ne lit pas les chiffres de cet article : réglez-les vous-même. Choisissez la ligne de plan la plus proche de votre profil (Small, Medium ou Large), puis ajustez les curseurs CPU (1-96), RAM (1-256 Go) et disque (20-960 Go) sur les valeurs de votre fiche.
- Ajoutez des copies de sauvegarde, des adresses IPv4 supplémentaires et des heures d'administration, puis lisez le prix mensuel complet, pas le prix "à partir de". L'administration gérée commence à EUR 30 pour deux heures.
Vérifié d'après la grille tarifaire le 2026-10-14 : Medium avec 3 sauvegardes coûte EUR 21.47, et la même CPU avec 16 Go de RAM EUR 29.95. La RAM est ce qui fait le plus varier le prix.
Configurer un serveur cloud pour votre application
Quand séparer la base de données ou passer au dédié
- Séparez la BD quand elle exige plus de la moitié de la mémoire de la VM, quand l'API et la BD se brident mutuellement sur la CPU, ou quand vous voulez un rythme de restauration distinct. Voir le guide PostgreSQL.
- Passez au dédié quand une charge occupe plus de 70% de toutes les vCPU au pic, demande plus que les 96 vCPU ou 256 Go de RAM d'un serveur cloud, ou exige une latence disque prévisible. Voir les serveurs dédiés.
Modèle de migration et de retour arrière
Répétez-le d'abord sur le nouveau serveur.
| Étape | Action | Retour arrière |
|---|---|---|
| 1 | Restaurer un dump récent sur le nouveau serveur, lancer l'appli et la soumettre à un test de charge | supprimer le nouveau serveur |
| 2 | Geler les écritures, faire le dump final, restaurer, comparer les nombres de lignes | rouvrir les écritures sur l'ancien serveur |
| 3 | Basculer le DNS (TTL abaissé à 300 s un ancien TTL complet à l'avance), tester connexion, commande, tâche et courrier | remettre le DNS d'origine |
| 4 | Garder l'ancien serveur en lecture seule au moins une semaine | rejouer les nouvelles écritures côté ancien |
Fiche de dimensionnement
Imprimez-la et remplissez la colonne de droite avec vos propres mesures.
| Poste | Comment l'obtenir | Votre valeur |
|---|---|---|
| Requêtes par seconde au pic | analytique ou test de charge | |
| p95 cible et taux d'échec | votre SLO, par exemple 300 ms et 1% | |
| Processus d'API | un par vCPU | |
| Limite mémoire du conteneur | RSS de pointe sous charge plus marge | |
| Connexions à la BD | pools x processus, sous max_connections |
|
| Mémoire libre conservée | 20-25% de la VM | |
| Disque | données et croissance + WAL + logs + images + dump temporaire, puis 20% libre | |
| Sauvegardes | nombre de copies, temps de restauration mesuré | |
| Prix mensuel | total du configurateur avec sauvegardes, IPv4, administration, date |
Le reproduire
Il vous faut Docker avec Compose, curl, openssl et vmstat ; l'image k6 est téléchargée au premier lancement. Les fichiers sont ceux que nous avons exécutés, avec ces versions. Les tags postgres:17-alpine, redis:7-alpine et node:22-alpine sont mobiles et npm install n'a pas de fichier de verrouillage : figez les tags et les versions si vous voulez le même résultat.
compose.yaml
# "Small production" starting hypothesis for a 4 vCPU / 8 GB VM: limits sum to 4.0 CPU and 3.2 GB
name: saas-sizing

x-logging: &logging
  driver: json-file
  options: { max-size: 10m, max-file: "3" }   # logs cannot fill the disk

services:
  proxy:
    build: { context: ., dockerfile: Dockerfile.proxy }
    ports: ["127.0.0.1:8080:80"]        # the only published port, loopback only
    depends_on:
      api: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1/healthz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "1.0", memory: 64M } } }
    logging: *logging
    restart: unless-stopped

  api:
    build: .
    command: ["node", "--max-old-space-size=192", "src/api.js"]
    env_file: [.env]
    environment:
      PG_POOL: "10"
    expose: ["3000"]
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000/readyz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy:
      replicas: 2
      resources: { limits: { cpus: "0.5", memory: 320M } }
    logging: *logging
    restart: unless-stopped

  worker:
    build: .
    command: ["node", "--max-old-space-size=128", "src/worker.js"]
    env_file: [.env]
    environment:
      PG_POOL: "3"
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD-SHELL", "pgrep -f src/worker.js >/dev/null"]
      interval: 15s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

  db:
    image: postgres:17-alpine
    env_file: [.env]
    command: [postgres,
      -c, shared_buffers=512MB, -c, effective_cache_size=1536MB,
      -c, work_mem=8MB, -c, maintenance_work_mem=128MB,
      -c, max_connections=50, -c, max_wal_size=1GB,
      -c, shared_preload_libraries=pg_stat_statements,
      -c, log_min_duration_statement=250, -c, track_io_timing=on]
    volumes: ["pgdata:/var/lib/postgresql/data"]
    # no "ports": reachable only from the compose network
    shm_size: 256m
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $$POSTGRES_USER -d $$POSTGRES_DB"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "1.5", memory: 2G } } }
    logging: *logging
    restart: unless-stopped

  redis:
    image: redis:7-alpine
    env_file: [.env]
    command: ["sh", "-c", "exec redis-server --requirepass \"$$REDIS_PASSWORD\" --maxmemory 128mb --maxmemory-policy noeviction --appendonly yes"]
    volumes: ["redisdata:/data"]
    healthcheck:
      test: ["CMD-SHELL", "REDISCLI_AUTH=\"$$REDIS_PASSWORD\" redis-cli ping | grep -q PONG"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

volumes:
  pgdata:
  redisdata:
Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package.json ./
RUN npm install --omit=dev --no-audit --no-fund
COPY src ./src
USER node
Dockerfile.proxy
FROM nginx:1.27-alpine
COPY nginx.conf /etc/nginx/nginx.conf
nginx.conf
worker_processes 1;
events { worker_connections 1024; }
http {
  access_log off;
  # resolved once at start: restart the proxy if the api containers get new addresses
  upstream api {
    server api:3000;
    keepalive 32;   # reuse upstream connections instead of one TCP connect per request
  }
  server {
    listen 80;
    location = /healthz { return 200 "ok\n"; }
    location / {
      proxy_pass http://api;
      proxy_http_version 1.1;
      proxy_set_header Connection "";
      proxy_set_header Host $host;
      proxy_read_timeout 10s;
    }
  }
}
package.json
{
  "name": "saas-sizing-example",
  "private": true,
  "type": "module",
  "dependencies": {
    "ioredis": "5.4.1",
    "pg": "8.13.1"
  }
}
src/db.js
import pg from 'pg'
import Redis from 'ioredis'

// pool size x processes must stay under Postgres max_connections (see the budget table)
export const pool = new pg.Pool({
  connectionString: process.env.DATABASE_URL,
  max: Number(process.env.PG_POOL || 10),
  statement_timeout: 5000,
})
export const redis = new Redis(process.env.REDIS_URL, { maxRetriesPerRequest: 2 })
src/api.js
import http from 'node:http'
import { pool, redis } from './db.js'

const json = (res, code, body) => {
  res.writeHead(code, { 'content-type': 'application/json' })
  res.end(JSON.stringify(body))
}
const readBody = req => new Promise((ok, fail) => {
  let s = ''
  req.on('data', c => { s += c; if (s.length > 4096) req.destroy() })
  req.on('end', () => ok(s))
  req.on('error', fail)
})

const routes = {
  'GET /healthz': (req, res) => json(res, 200, { ok: true }),
  // readiness touches both stores; the container healthcheck uses it
  'GET /readyz': async (req, res) => {
    await pool.query('select 1')
    await redis.ping()
    json(res, 200, { ok: true })
  },
  'GET /api/tasks': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select id, title, status from tasks where account_id = $1 order by id desc limit 20', [account])
    json(res, 200, rows)
  },
  'GET /api/report': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select status, count(*)::int as n from tasks where account_id = $1 group by status', [account])
    json(res, 200, rows)
  },
  'POST /api/tasks': async (req, res) => {
    let b
    try { b = JSON.parse(await readBody(req)) } catch { return json(res, 400, { error: 'json' }) }
    const account = Number(b.account)
    if (!Number.isInteger(account) || account < 1 || typeof b.title !== 'string' || b.title.length > 200) {
      return json(res, 400, { error: 'input' })
    }
    const { rows } = await pool.query(
      "insert into tasks (account_id, title) values ($1, $2) returning id", [account, b.title])
    await redis.lpush('jobs', String(rows[0].id))
    json(res, 201, { id: rows[0].id })
  },
}

const server = http.createServer(async (req, res) => {
  const url = new URL(req.url, 'http://x')
  const h = routes[`${req.method} ${url.pathname}`]
  if (!h) return json(res, 404, { error: 'not found' })
  try { await h(req, res, url) } catch (e) {
    console.error(e.message)
    json(res, 503, { error: 'unavailable' })
  }
})
server.listen(3000, () => console.log('api up'))

// compose sends SIGTERM on stop: finish in-flight requests, then close the stores
process.on('SIGTERM', () => server.close(async () => { await pool.end(); redis.disconnect(); process.exit(0) }))
src/worker.js
import { createHash } from 'node:crypto'
import { pool, redis } from './db.js'

let stop = false
process.on('SIGTERM', () => { stop = true })

// stands in for real background work (mail, PDF, webhook): a little CPU, then one UPDATE
const work = title => {
  let h = title
  for (let i = 0; i < 2000; i++) h = createHash('sha256').update(h).digest('hex')
  return h.slice(0, 16)
}

console.log('worker up')
while (!stop) {
  const r = await redis.brpop('jobs', 2)
  if (!r) continue
  const id = Number(r[1])
  const { rows } = await pool.query('select title from tasks where id = $1', [id])
  if (!rows.length) continue
  await pool.query("update tasks set status = 'done', result = $2 where id = $1", [id, work(rows[0].title)])
}
await pool.end()
redis.disconnect()
init.sql
create extension if not exists pg_stat_statements;
create table tasks (
  id bigserial primary key,
  account_id int not null,
  title text not null,
  status text not null default 'open',
  result text,
  created_at timestamptz not null default now()
);
create index tasks_account_id_idx on tasks (account_id, id desc);
seed.sql
-- 1,000,000 tasks for 2,000 accounts (about 500 each), 70% done
insert into tasks (account_id, title, status)
select 1 + (g % 2000), 'task ' || g, case when g % 10 < 7 then 'done' else 'open' end
from generate_series(1, 1000000) g;
analyze tasks;
make-env.sh
#!/bin/sh
# writes .env with random secrets; never commit it, and never reuse these values elsewhere
set -eu
[ -e .env ] && { echo ".env exists, not overwriting"; exit 1; }
PG=$(openssl rand -hex 24)
RD=$(openssl rand -hex 24)
umask 077
cat > .env <<EOF
POSTGRES_USER=app
POSTGRES_PASSWORD=$PG
POSTGRES_DB=app
REDIS_PASSWORD=$RD
DATABASE_URL=postgres://app:$PG@db:5432/app
REDIS_URL=redis://:$RD@redis:6379
EOF
k6.js
import http from 'k6/http'
import { check } from 'k6'

const BASE = __ENV.BASE || 'http://proxy'
const RATE = Number(__ENV.RATE || 100)

// open model: requests arrive at RATE per second whether or not the server keeps up,
// which is how real users behave (closed-loop VUs hide overload)
export const options = {
  scenarios: {
    mixed: {
      executor: 'constant-arrival-rate',
      rate: RATE,
      timeUnit: '1s',
      duration: __ENV.DURATION || '30s',
      preAllocatedVUs: 50,
      maxVUs: 500,
    },
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
  },
  summaryTrendStats: ['avg', 'med', 'p(90)', 'p(95)', 'p(99)', 'max'],
}

export default function () {
  const account = 1 + Math.floor(Math.random() * 2000)
  const r = Math.random()
  let res
  if (r < 0.80) res = http.get(`${BASE}/api/tasks?account=${account}`)
  else if (r < 0.90) res = http.get(`${BASE}/api/report?account=${account}`)
  else res = http.post(`${BASE}/api/tasks`, JSON.stringify({ account, title: 'k6 task' }),
    { headers: { 'content-type': 'application/json' } })
  check(res, { 'status 200/201': x => x.status === 200 || x.status === 201 })
}
bench.sh
#!/bin/sh
# usage: ./bench.sh 200 500 1000   (requests per second, one 40 s step each)
set -eu
NET=$(docker compose ps -q proxy | xargs docker inspect --format '{{range $k, $v := .NetworkSettings.Networks}}{{$k}}{{end}}')
for RATE in "$@"; do
  echo "=== ${RATE} req/s"
  # mid-run snapshot of container CPU / memory and host CPU steal ("st") and swap ("si so")
  ( sleep 20; docker stats --no-stream --format '{{.Name}} cpu={{.CPUPerc}} mem={{.MemUsage}}' $(docker compose ps -q); vmstat 5 2 | tail -1 ) &
  docker run --rm -i --network "$NET" -e RATE="$RATE" -e DURATION=40s \
    grafana/k6 run --quiet - < k6.js 2>&1 | grep -E 'http_req_duration\.|http_req_failed\.|http_reqs|dropped_iterations|vus_max'
  wait
done
sh make-env.sh
docker compose up -d --build
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < init.sql
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < seed.sql
curl -s http://127.0.0.1:8080/readyz
./bench.sh 500 1000
docker compose down -v
Vos chiffres seront différents. Faites-leur alors confiance plutôt qu'aux nôtres, puis configurez un serveur cloud pour votre application ou écrivez à sales@dcxv.com.