Jak dobrać serwer cloud do SaaS: CPU, RAM, NVMe i backupy
Aby dobrać serwer cloud do aplikacji SaaS, nie zaczynaj od liczby użytkowników. Zacznij od pamięci na proces, potem ustal CPU na kontener, następnie dysk na dane, WAL i backupy, a każde założenie sprawdź testem obciążeniowym. Ten poradnik robi to na jednym prawdziwym przykładzie: API i worker w Node.js, PostgreSQL, Redis i nginx w Docker Compose, przetestowane na jednej maszynie. Poniższe profile to hipotezy wyjściowe; proste zakresy startowe znajdziesz w poradniku doboru.
Przykładowy stos
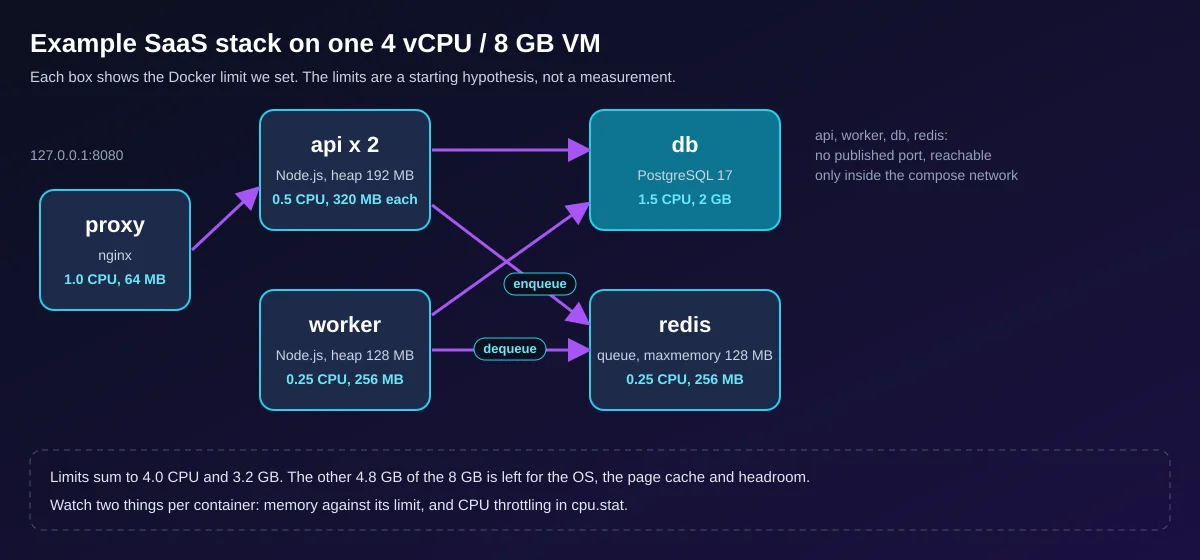
Przykład to API do zarządzania zadaniami: proxy nginx, dwie repliki API w Node.js, worker opróżniający kolejkę Redis, PostgreSQL 17 i Redis 7. Tylko proxy publikuje port, i to wyłącznie na loopbacku. Sekrety leżą w niecommitowanym pliku .env, każda usługa ma healthcheck i limit zasobów, a logi są rotowane. Monitoring to tu docker stats, liczniki cgroup i pg_stat_statements. Samego Node.js dotyczy poradnik Serwer Cloud dla Node.js. Pełne pliki są na końcu.
Dlaczego użytkownicy nie przeliczają się na vCPU
- Współbieżność, a nie liczba osób - żądania w toku = tempo napływu x czas jednego żądania (prawo Little'a). 1000 użytkowników klikających raz na minutę to około 17 żądań na sekundę; jeden skrypt odpytujący co sekundę daje to samo obciążenie co 60 takich użytkowników.
- Koszt SQL i model wykonania - w naszym przebiegu zapytanie raportowe zajmowało średnio 1,07 ms według
pg_stat_statements, a zapytanie o listę 0,07 ms, czyli około 15 razy mniej. Jeden proces Node.js wykorzystuje mniej więcej jeden rdzeń, więc vCPU dla API to liczba procesów, a nie użytkowników. - Gniazda, zadania i szczyty - otwarty WebSocket trzyma pamięć przez cały swój czas życia, zadanie w tle konkuruje z żądaniami o te same rdzenie, a liczyć trzeba na najbardziej obciążoną godzinę, nie na średnią.
Trzy profile startowe
To hipotezy, a nie pomiary. Ceny to kwoty miesięczne dla Pragi, przeliczone według cennika 2026-10-14.
| Profil | Specyfikacja startowa | Cena miesięczna, podstawa |
|---|---|---|
| Dev / staging | 2 vCPU, 4 GB RAM, 40 GB NVMe (Small) | EUR 15.00, 1 backup |
| Mała produkcja | 4 vCPU, 8 GB RAM, 80 GB NVMe (Medium), przykład w opublikowanej postaci | EUR 18.43, 1 backup |
| Rosnący SaaS, jeden serwer | 8 vCPU, 16 GB RAM, 160 GB NVMe (Large) | EUR 36.88, 1 backup |
| Rosnący SaaS, rozdzielony | serwer aplikacji Medium plus serwer bazy: 4 vCPU, 16 GB RAM, 160 GB NVMe | EUR 18.43 (1 backup) + EUR 39.05 (3 backupy) = EUR 57.48 |
Arytmetyka pamięci, dysku i backupów
Limity poniżej ustawia plik compose; ostatnia kolumna to pamięć rezydentna, jaką pokazał docker stats podczas naszych etapów obciążenia, ze wszystkich przebiegów.
| Kontener | Limit | Ustawienie | Pod obciążeniem |
|---|---|---|---|
| proxy | 64 MB | nginx, jeden worker | 3-18 MB |
| api (x2) | po 320 MB | --max-old-space-size=192, pula 10 |
po 21-34 MB |
| worker | 256 MB | sterta 128 MB, pula 3 | 19-34 MB |
| db | 2 GB | shared_buffers 512 MB, work_mem 8 MB |
207-252 MB |
| redis | 256 MB | maxmemory 128 MB, bez wypierania |
4-7 MB |
Limity sumują się do 3,2 GB, więc 4,8 GB z 8 GB maszyny wirtualnej zostaje dla systemu i cache'u stron. Liczby wynikają z trzech reguł. Po pierwsze, shared_buffers zaczyna się od 25% pamięci dedykowanego serwera bazy (dokumentacja PostgreSQL, sprawdzono 2026-10-14): 25% z 2 GB kontenera to 512 MB. Po drugie, work_mem dotyczy pojedynczej operacji sortowania lub haszowania, a nie połączenia, więc suma może być wielokrotnością ustawionej wartości: 23 połączenia aplikacji po 8 MB z dwiema takimi operacjami każde dają najgorszy przypadek 368 MB. Po trzecie, pule pomnożone przez procesy (2 x 10 + 3 = 23) muszą pozostać poniżej max_connections (50).
Dysk i backupy. Po około 1,04 mln wierszy baza miała 146 MB, ale katalog danych 457 MB, z czego 288 MB to pg_wal: WAL zależy od max_wal_size (limitu miękkiego), a nie od rozmiaru danych, więc zaplanuj go i zostaw wolne ponad 20% dysku. Na tym malutkim zbiorze danych pg_dump -Fc zajął 0,59 s (7 MB), a odtworzenie 1,78 s; Twój czas odtwarzania to Twój czas niedostępności, więc go zmierz. Każda cena DCXV Cloud zawiera jeden cotygodniowy backup dysku: to kopia bezpieczeństwa, a nie miejsce na Twoje pliki.
Znajdź wąskie gardło za pomocą k6
Najpierw ustal warunek zaliczenia (tu p95 poniżej 300 ms i mniej niż 1% nieudanych żądań), użyj modelu otwartego (constant-arrival-rate, zobacz dokumentację k6), zwiększaj tempo stopniami i obserwuj jednocześnie poniższe sygnały.
| Sygnał | Polecenie | Zły znak |
|---|---|---|
| p95, błędy, porzucone iteracje | podsumowanie k6 | p95 powyżej celu, serwer nie nadąża za tempem napływu |
| Throttling CPU | grep nr_throttled /sys/fs/cgroup/cpu.stat w kontenerze |
rośnie w trakcie stopnia (dokumentacja jądra) |
| CPU steal | vmstat 5, kolumna st |
powyżej 0 na VM: host jest przeciążony |
| Presja pamięci | docker stats, vmstat kolumny si so |
blisko limitu lub swapowanie |
Zmierzono na 12-rdzeniowej maszynie z Linuksem arm64 i 14,4 GB RAM, Docker 29.7.2, k6 2.3.0, PostgreSQL 17.11, Node.js 22.23.3, nginx 1.27.5, Redis 7.4.11, 2026-10-14, jeden przebieg 40 s na stopień, chyba że podano dwie wartości. To nie jest DCXV Cloud. k6 dzielił CPU ze stosem, a host dodatkowo używał swapa, więc opóźnienia są zawyżone: do prawdziwego testu uruchom k6 z drugiej maszyny. "Porzucone" to nadejścia, które k6 pominął, bo wszystkich 500 wirtualnych użytkowników było zajętych.
| Konfig nginx | Zadane żąd./s | Osiągnięte żąd./s | p95 | Nieudane | Porzucone |
|---|---|---|---|---|---|
| A, proxy 0,25 CPU | 1000 | 610 | 2,11 s | 0,03% | 15 595 |
| A, proxy 1,0 CPU | 1000 | 994 i 997 | 150 ms i 51,5 ms | 0% | 207 i 121 |
| A, proxy 1,0 CPU | 2000 | 941 | 1,77 s | 6,56% | 42 356 |
| B, keepalive | 1000 | 999 i 1000 | 2,66 ms i 2,42 ms | 0% | 36 i 0 |
| B, keepalive | 5000 | 4995 | 1,48 ms | 0% | 206 |
| B, keepalive | 8000 | 7918 | 23,1 ms | 0,02% | 2532 |
Lekcja dotyczy metody, a nie przepustowości. Konfig A używał proxy_pass ze zmienną i bez bloku upstream, więc nginx otwierał nowe połączenie TCP do API przy każdym żądaniu. Proxy jako pierwsze doszło do limitu CPU (cpu.stat: 1512 z 2787 okresów z throttlingiem przy 0,25 CPU, a przy 1,0 CPU nadal sufit około 940 żąd./s), podczas gdy baza zużywała wyraźnie mniej niż połowę swojego limitu. Konfig B, czyli upstream z keepalive 32, utrzymał proxy w okolicach jednej trzeciej CPU przy 8000 żąd./s. Kolejne limity pojawiły się potem w tych samych licznikach: baza weszła w throttling w 301 z 2790 okresów, a worker z limitem 0,25 CPU niemal w każdym okresie i zostawił w kolejce 46 982 zadania (LLEN jobs). Zbiór danych 146 MB mieści się w pamięci, więc nic z tego nie dotykało dysku. Kontrola fio na pliku tymczasowym (fio --name=w --filename=fio.tmp --size=256M --rw=write --bs=8k --fdatasync=1 --ioengine=sync --runtime=15 --time_based) pokazała 700 synchronicznych zapisów na sekundę, po około 1,4 ms; przebieg losowego odczytu (fio --name=r --filename=fio.tmp --size=256M --rw=randread --bs=4k --iodepth=32 --ioengine=libaio --direct=1 --runtime=15 --time_based) podał 399 000 IOPS, a to jest cache stron, nie dysk.
Wyceń wynik w konfiguratorze
- Otwórz stronę serwerów cloud. Nie odczytuje ona liczb z tego artykułu, więc ustaw je samodzielnie: wybierz wiersz planu najbliższy Twojemu profilowi (Small, Medium lub Large), a potem dopasuj suwaki CPU (1-96), RAM (1-256 GB) i dysku (20-960 GB) do wartości z arkusza.
- Dodaj kopie backupu, dodatkowe adresy IPv4 i godziny administracji, po czym odczytaj pełną cenę miesięczną, a nie cenę "od". Administracja zarządzana zaczyna się od EUR 30 za dwie godziny.
Sprawdzono według cennika 2026-10-14: Medium z 3 backupami kosztuje EUR 21.47, a to samo CPU z 16 GB RAM EUR 29.95. Najmocniej cenę zmienia RAM.
Skonfiguruj serwer cloud dla swojej aplikacji
Kiedy wydzielić bazę danych lub przejść na dedykowany
- Wydziel bazę, gdy potrzebuje ponad połowy pamięci VM, gdy API i baza wzajemnie wpadają w throttling na CPU albo gdy chcesz osobnego rytmu odtwarzania. Zobacz poradnik o PostgreSQL.
- Przejdź na dedykowany, gdy jedno obciążenie w szczycie zajmuje ponad 70% wszystkich vCPU, wymaga więcej niż 96 vCPU lub 256 GB RAM oferowanych przez serwer cloud albo wymaga przewidywalnego opóźnienia dysku. Zobacz serwery dedykowane.
Szablon migracji i wycofania
Przećwicz go najpierw na nowym serwerze.
| Krok | Działanie | Wycofanie |
|---|---|---|
| 1 | Odtwórz świeży zrzut na nowym serwerze, uruchom aplikację i poddaj ją testowi obciążeniowemu | usuń nowy serwer |
| 2 | Zamroź zapisy, zrób końcowy zrzut, odtwórz, porównaj liczby wierszy | otwórz ponownie zapisy na starym serwerze |
| 3 | Przełącz DNS (TTL obniżony do 300 s z wyprzedzeniem równym pełnemu staremu TTL), sprawdź logowanie, zamówienie, zadanie i pocztę | przywróć DNS |
| 4 | Trzymaj stary serwer w trybie tylko do odczytu co najmniej tydzień | odtwórz nowe zapisy po starej stronie |
Arkusz doboru zasobów
Wydrukuj go i wypełnij prawą kolumnę własnymi pomiarami.
| Pozycja | Jak uzyskać | Twoja wartość |
|---|---|---|
| Szczytowe żądania na sekundę | analityka lub test obciążeniowy | |
| Docelowe p95 i odsetek błędów | Twoje SLO, na przykład 300 ms i 1% | |
| Procesy API | jeden na vCPU | |
| Limit pamięci kontenera | szczytowy RSS pod obciążeniem plus zapas | |
| Połączenia z bazą | pule x procesy, poniżej max_connections |
|
| Wolna pamięć | 20-25% VM | |
| Dysk | dane i przyrost + WAL + logi + obrazy + tymczasowy zrzut, potem 20% wolne | |
| Backupy | ile kopii, zmierzony czas odtwarzania | |
| Cena miesięczna | suma z konfiguratora z backupami, IPv4, administracją i datą |
Odtwórz to u siebie
Potrzebujesz Dockera z Compose, curl, openssl i vmstat; obraz k6 jest pobierany przy pierwszym uruchomieniu. Pliki są tymi, które uruchomiliśmy, w podanych wersjach. Tagi postgres:17-alpine, redis:7-alpine i node:22-alpine są ruchome, a npm install nie ma pliku blokady, więc przypnij tagi i wersje, jeśli potrzebujesz tego samego wyniku.
compose.yaml
# "Small production" starting hypothesis for a 4 vCPU / 8 GB VM: limits sum to 4.0 CPU and 3.2 GB
name: saas-sizing

x-logging: &logging
  driver: json-file
  options: { max-size: 10m, max-file: "3" }   # logs cannot fill the disk

services:
  proxy:
    build: { context: ., dockerfile: Dockerfile.proxy }
    ports: ["127.0.0.1:8080:80"]        # the only published port, loopback only
    depends_on:
      api: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1/healthz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "1.0", memory: 64M } } }
    logging: *logging
    restart: unless-stopped

  api:
    build: .
    command: ["node", "--max-old-space-size=192", "src/api.js"]
    env_file: [.env]
    environment:
      PG_POOL: "10"
    expose: ["3000"]
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000/readyz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy:
      replicas: 2
      resources: { limits: { cpus: "0.5", memory: 320M } }
    logging: *logging
    restart: unless-stopped

  worker:
    build: .
    command: ["node", "--max-old-space-size=128", "src/worker.js"]
    env_file: [.env]
    environment:
      PG_POOL: "3"
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD-SHELL", "pgrep -f src/worker.js >/dev/null"]
      interval: 15s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

  db:
    image: postgres:17-alpine
    env_file: [.env]
    command: [postgres,
      -c, shared_buffers=512MB, -c, effective_cache_size=1536MB,
      -c, work_mem=8MB, -c, maintenance_work_mem=128MB,
      -c, max_connections=50, -c, max_wal_size=1GB,
      -c, shared_preload_libraries=pg_stat_statements,
      -c, log_min_duration_statement=250, -c, track_io_timing=on]
    volumes: ["pgdata:/var/lib/postgresql/data"]
    # no "ports": reachable only from the compose network
    shm_size: 256m
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $$POSTGRES_USER -d $$POSTGRES_DB"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "1.5", memory: 2G } } }
    logging: *logging
    restart: unless-stopped

  redis:
    image: redis:7-alpine
    env_file: [.env]
    command: ["sh", "-c", "exec redis-server --requirepass \"$$REDIS_PASSWORD\" --maxmemory 128mb --maxmemory-policy noeviction --appendonly yes"]
    volumes: ["redisdata:/data"]
    healthcheck:
      test: ["CMD-SHELL", "REDISCLI_AUTH=\"$$REDIS_PASSWORD\" redis-cli ping | grep -q PONG"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

volumes:
  pgdata:
  redisdata:
Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package.json ./
RUN npm install --omit=dev --no-audit --no-fund
COPY src ./src
USER node
Dockerfile.proxy
FROM nginx:1.27-alpine
COPY nginx.conf /etc/nginx/nginx.conf
nginx.conf
worker_processes 1;
events { worker_connections 1024; }
http {
  access_log off;
  # resolved once at start: restart the proxy if the api containers get new addresses
  upstream api {
    server api:3000;
    keepalive 32;   # reuse upstream connections instead of one TCP connect per request
  }
  server {
    listen 80;
    location = /healthz { return 200 "ok\n"; }
    location / {
      proxy_pass http://api;
      proxy_http_version 1.1;
      proxy_set_header Connection "";
      proxy_set_header Host $host;
      proxy_read_timeout 10s;
    }
  }
}
package.json
{
  "name": "saas-sizing-example",
  "private": true,
  "type": "module",
  "dependencies": {
    "ioredis": "5.4.1",
    "pg": "8.13.1"
  }
}
src/db.js
import pg from 'pg'
import Redis from 'ioredis'

// pool size x processes must stay under Postgres max_connections (see the budget table)
export const pool = new pg.Pool({
  connectionString: process.env.DATABASE_URL,
  max: Number(process.env.PG_POOL || 10),
  statement_timeout: 5000,
})
export const redis = new Redis(process.env.REDIS_URL, { maxRetriesPerRequest: 2 })
src/api.js
import http from 'node:http'
import { pool, redis } from './db.js'

const json = (res, code, body) => {
  res.writeHead(code, { 'content-type': 'application/json' })
  res.end(JSON.stringify(body))
}
const readBody = req => new Promise((ok, fail) => {
  let s = ''
  req.on('data', c => { s += c; if (s.length > 4096) req.destroy() })
  req.on('end', () => ok(s))
  req.on('error', fail)
})

const routes = {
  'GET /healthz': (req, res) => json(res, 200, { ok: true }),
  // readiness touches both stores; the container healthcheck uses it
  'GET /readyz': async (req, res) => {
    await pool.query('select 1')
    await redis.ping()
    json(res, 200, { ok: true })
  },
  'GET /api/tasks': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select id, title, status from tasks where account_id = $1 order by id desc limit 20', [account])
    json(res, 200, rows)
  },
  'GET /api/report': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select status, count(*)::int as n from tasks where account_id = $1 group by status', [account])
    json(res, 200, rows)
  },
  'POST /api/tasks': async (req, res) => {
    let b
    try { b = JSON.parse(await readBody(req)) } catch { return json(res, 400, { error: 'json' }) }
    const account = Number(b.account)
    if (!Number.isInteger(account) || account < 1 || typeof b.title !== 'string' || b.title.length > 200) {
      return json(res, 400, { error: 'input' })
    }
    const { rows } = await pool.query(
      "insert into tasks (account_id, title) values ($1, $2) returning id", [account, b.title])
    await redis.lpush('jobs', String(rows[0].id))
    json(res, 201, { id: rows[0].id })
  },
}

const server = http.createServer(async (req, res) => {
  const url = new URL(req.url, 'http://x')
  const h = routes[`${req.method} ${url.pathname}`]
  if (!h) return json(res, 404, { error: 'not found' })
  try { await h(req, res, url) } catch (e) {
    console.error(e.message)
    json(res, 503, { error: 'unavailable' })
  }
})
server.listen(3000, () => console.log('api up'))

// compose sends SIGTERM on stop: finish in-flight requests, then close the stores
process.on('SIGTERM', () => server.close(async () => { await pool.end(); redis.disconnect(); process.exit(0) }))
src/worker.js
import { createHash } from 'node:crypto'
import { pool, redis } from './db.js'

let stop = false
process.on('SIGTERM', () => { stop = true })

// stands in for real background work (mail, PDF, webhook): a little CPU, then one UPDATE
const work = title => {
  let h = title
  for (let i = 0; i < 2000; i++) h = createHash('sha256').update(h).digest('hex')
  return h.slice(0, 16)
}

console.log('worker up')
while (!stop) {
  const r = await redis.brpop('jobs', 2)
  if (!r) continue
  const id = Number(r[1])
  const { rows } = await pool.query('select title from tasks where id = $1', [id])
  if (!rows.length) continue
  await pool.query("update tasks set status = 'done', result = $2 where id = $1", [id, work(rows[0].title)])
}
await pool.end()
redis.disconnect()
init.sql
create extension if not exists pg_stat_statements;
create table tasks (
  id bigserial primary key,
  account_id int not null,
  title text not null,
  status text not null default 'open',
  result text,
  created_at timestamptz not null default now()
);
create index tasks_account_id_idx on tasks (account_id, id desc);
seed.sql
-- 1,000,000 tasks for 2,000 accounts (about 500 each), 70% done
insert into tasks (account_id, title, status)
select 1 + (g % 2000), 'task ' || g, case when g % 10 < 7 then 'done' else 'open' end
from generate_series(1, 1000000) g;
analyze tasks;
make-env.sh
#!/bin/sh
# writes .env with random secrets; never commit it, and never reuse these values elsewhere
set -eu
[ -e .env ] && { echo ".env exists, not overwriting"; exit 1; }
PG=$(openssl rand -hex 24)
RD=$(openssl rand -hex 24)
umask 077
cat > .env <<EOF
POSTGRES_USER=app
POSTGRES_PASSWORD=$PG
POSTGRES_DB=app
REDIS_PASSWORD=$RD
DATABASE_URL=postgres://app:$PG@db:5432/app
REDIS_URL=redis://:$RD@redis:6379
EOF
k6.js
import http from 'k6/http'
import { check } from 'k6'

const BASE = __ENV.BASE || 'http://proxy'
const RATE = Number(__ENV.RATE || 100)

// open model: requests arrive at RATE per second whether or not the server keeps up,
// which is how real users behave (closed-loop VUs hide overload)
export const options = {
  scenarios: {
    mixed: {
      executor: 'constant-arrival-rate',
      rate: RATE,
      timeUnit: '1s',
      duration: __ENV.DURATION || '30s',
      preAllocatedVUs: 50,
      maxVUs: 500,
    },
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
  },
  summaryTrendStats: ['avg', 'med', 'p(90)', 'p(95)', 'p(99)', 'max'],
}

export default function () {
  const account = 1 + Math.floor(Math.random() * 2000)
  const r = Math.random()
  let res
  if (r < 0.80) res = http.get(`${BASE}/api/tasks?account=${account}`)
  else if (r < 0.90) res = http.get(`${BASE}/api/report?account=${account}`)
  else res = http.post(`${BASE}/api/tasks`, JSON.stringify({ account, title: 'k6 task' }),
    { headers: { 'content-type': 'application/json' } })
  check(res, { 'status 200/201': x => x.status === 200 || x.status === 201 })
}
bench.sh
#!/bin/sh
# usage: ./bench.sh 200 500 1000   (requests per second, one 40 s step each)
set -eu
NET=$(docker compose ps -q proxy | xargs docker inspect --format '{{range $k, $v := .NetworkSettings.Networks}}{{$k}}{{end}}')
for RATE in "$@"; do
  echo "=== ${RATE} req/s"
  # mid-run snapshot of container CPU / memory and host CPU steal ("st") and swap ("si so")
  ( sleep 20; docker stats --no-stream --format '{{.Name}} cpu={{.CPUPerc}} mem={{.MemUsage}}' $(docker compose ps -q); vmstat 5 2 | tail -1 ) &
  docker run --rm -i --network "$NET" -e RATE="$RATE" -e DURATION=40s \
    grafana/k6 run --quiet - < k6.js 2>&1 | grep -E 'http_req_duration\.|http_req_failed\.|http_reqs|dropped_iterations|vus_max'
  wait
done
sh make-env.sh
docker compose up -d --build
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < init.sql
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < seed.sql
curl -s http://127.0.0.1:8080/readyz
./bench.sh 500 1000
docker compose down -v
Twoje liczby będą inne. Wtedy ufaj im, a nie naszym, i skonfiguruj serwer cloud dla swojej aplikacji lub napisz na sales@dcxv.com.