Як підібрати хмарний сервер для SaaS: CPU, RAM, NVMe, бекапи
Щоб підібрати хмарний сервер для SaaS-застосунку, не відштовхуйтеся від кількості користувачів. Почніть із пам'яті на процес, потім визначте CPU на контейнер, далі диск для даних, WAL і бекапів, а кожне припущення перевірте навантажувальним тестом. Цей посібник робить це на одному реальному прикладі: API і воркер на Node.js, PostgreSQL, Redis та nginx у Docker Compose, перевірені на одній машині. Профілі нижче є стартовими гіпотезами; прості стартові діапазони дивіться в посібнику з підбору.
Приклад стеку
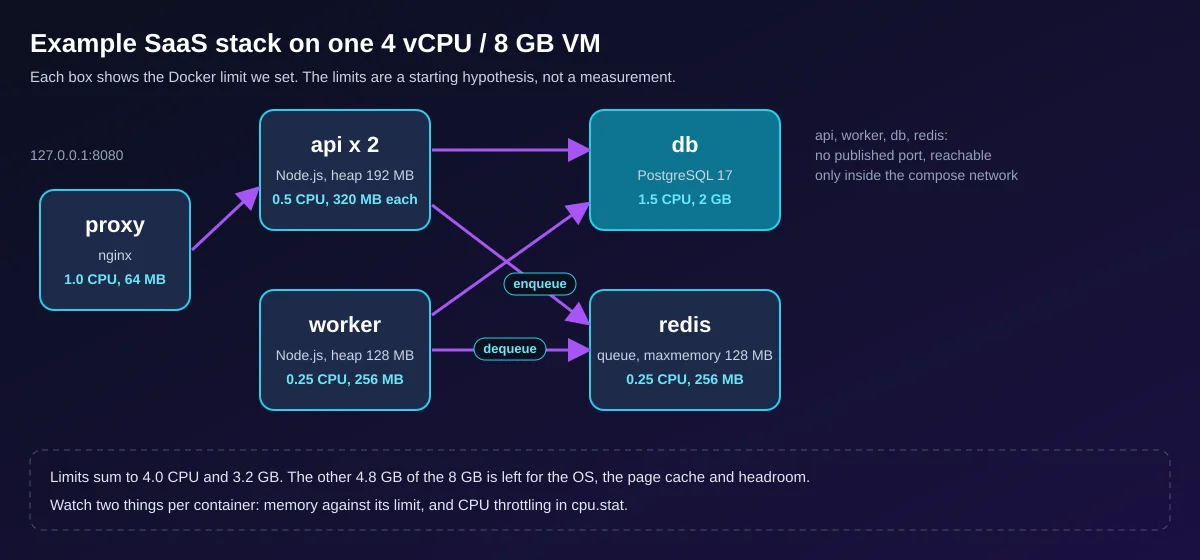
Приклад - це API для трекера завдань: проксі nginx, дві репліки API на Node.js, воркер, що розбирає чергу Redis, PostgreSQL 17 і Redis 7. Порт назовні відкриває лише проксі, і тільки на loopback. Секрети лежать у файлі .env, який не потрапляє до git, кожен сервіс має healthcheck і ліміт ресурсів, а логи ротуються. Моніторинг тут - це docker stats, лічильники cgroup і pg_stat_statements. Про сторону Node.js окремо дивіться Хмарний сервер для Node.js. Повні файли наведено наприкінці.
Чому користувачі не перетворюються на vCPU
- Паралелізм, а не кількість людей - запити в обробці = інтенсивність надходження x час на запит (закон Літтла). 1000 користувачів, що клацають раз на хвилину, дають близько 17 запитів на секунду; один скрипт, що опитує щосекунди, створює таке саме навантаження, як 60 таких користувачів.
- Вартість SQL і модель виконання - у нашому прогоні запит звіту в
pg_stat_statementsвиконувався в середньому 1,07 мс, а запит списку 0,07 мс, тобто різниця близько 15 разів. Один процес Node.js використовує приблизно одне ядро, тому vCPU для API - це кількість процесів, а не користувачів. - Сокети, завдання і піки - відкритий WebSocket тримає пам'ять увесь свій час життя, фонове завдання ділить ядра із запитами, а розраховувати треба на найзавантаженішу годину, а не на середню.
Три стартові профілі
Це гіпотези, а не виміри. Ціни - місячні суми для Праги, перераховані за прайсом 2026-10-14.
| Профіль | Стартова специфікація | Місячна ціна, база |
|---|---|---|
| Dev / staging | 2 vCPU, 4 ГБ RAM, 40 ГБ NVMe (Small) | EUR 15.00, 1 бекап |
| Мала production | 4 vCPU, 8 ГБ RAM, 80 ГБ NVMe (Medium), приклад у опублікованому вигляді | EUR 18.43, 1 бекап |
| SaaS, що росте, один сервер | 8 vCPU, 16 ГБ RAM, 160 ГБ NVMe (Large) | EUR 36.88, 1 бекап |
| SaaS, що росте, розділений | сервер застосунку Medium плюс сервер БД: 4 vCPU, 16 ГБ RAM, 160 ГБ NVMe | EUR 18.43 (1 бекап) + EUR 39.05 (3 бекапи) = EUR 57.48 |
Арифметика пам'яті, диска і бекапів
Ліміти нижче задає файл compose, а в останній колонці - резидентна пам'ять, яку показував docker stats під час наших кроків навантаження, за всі прогони.
| Контейнер | Ліміт | Налаштування | Під навантаженням |
|---|---|---|---|
| proxy | 64 МБ | nginx, один воркер | 3-18 МБ |
| api (x2) | по 320 МБ | --max-old-space-size=192, пул 10 |
по 21-34 МБ |
| worker | 256 МБ | купа 128 МБ, пул 3 | 19-34 МБ |
| db | 2 ГБ | shared_buffers 512 МБ, work_mem 8 МБ |
207-252 МБ |
| redis | 256 МБ | maxmemory 128 МБ, без витіснення |
4-7 МБ |
Ліміти разом дають 3,2 ГБ, тож 4,8 ГБ із 8 ГБ віртуальної машини лишаються ОС і кешу сторінок. Числа дають три правила. По-перше, shared_buffers починають із 25% пам'яті виділеної бази даних (документація PostgreSQL, перевірено 2026-10-14): 25% від 2 ГБ контейнера - це 512 МБ. По-друге, work_mem діє на кожну операцію сортування чи хешування, а не на з'єднання, тож сума може бути в багато разів більшою за задане значення: 23 з'єднання застосунку по 8 МБ із двома такими операціями кожне дають найгірший випадок 368 МБ. По-третє, пули помножені на процеси (2 x 10 + 3 = 23) мають лишатися нижче max_connections (50).
Диск і бекапи. Після приблизно 1,04 млн рядків база займала 146 МБ, а каталог даних - 457 МБ, із них 288 МБ - pg_wal: WAL залежить від max_wal_size (м'яке обмеження), а не від розміру даних, тому закладайте його окремо й залишайте вільними понад 20% диска. На цьому крихітному наборі даних pg_dump -Fc зайняв 0,59 с (7 МБ), а відновлення - 1,78 с; ваш час відновлення - це ваш простій, тож виміряйте його. У кожну ціну DCXV Cloud входить один тижневий бекап диска: це страхова копія, а не місце для ваших файлів.
Шукаємо вузьке місце за допомогою k6
Спершу зафіксуйте умову успіху (тут p95 нижче 300 мс і менше 1% невдалих запитів), використовуйте відкриту модель (constant-arrival-rate, див. документацію k6), піднімайте інтенсивність кроками й одночасно стежте за сигналами нижче.
| Сигнал | Команда | Погана ознака |
|---|---|---|
| p95, помилки, пропущені ітерації | підсумок k6 | p95 понад ціль, сервер не встигає за інтенсивністю надходження |
| Тротлінг CPU | grep nr_throttled /sys/fs/cgroup/cpu.stat у контейнері |
зростає під час кроку (документація ядра) |
| CPU steal | vmstat 5, стовпець st |
вище 0 на VM: хост перевантажений |
| Тиск на пам'ять | docker stats, vmstat, стовпці si so |
поблизу ліміту або свопінг |
Виміряно на 12-ядерній машині arm64 з Linux і 14,4 ГБ RAM, Docker 29.7.2, k6 2.3.0, PostgreSQL 17.11, Node.js 22.23.3, nginx 1.27.5, Redis 7.4.11, 2026-10-14, один прогін по 40 с на крок, якщо не наведено два значення. Це не DCXV Cloud. k6 ділив ядра CPU зі стеком, а хост ще й використовував своп, тож затримки завищені: для реального тесту запускайте k6 з другої машини. "Пропущено" - це надходження, які k6 пропустив, бо всі 500 віртуальних користувачів були зайняті.
| Конфіг nginx | Подано запитів/с | Досягнуто запитів/с | p95 | Невдалі | Пропущено |
|---|---|---|---|---|---|
| A, proxy 0,25 CPU | 1000 | 610 | 2,11 с | 0,03% | 15 595 |
| A, proxy 1,0 CPU | 1000 | 994 і 997 | 150 мс і 51,5 мс | 0% | 207 і 121 |
| A, proxy 1,0 CPU | 2000 | 941 | 1,77 с | 6,56% | 42 356 |
| B, keepalive | 1000 | 999 і 1000 | 2,66 мс і 2,42 мс | 0% | 36 і 0 |
| B, keepalive | 5000 | 4995 | 1,48 мс | 0% | 206 |
| B, keepalive | 8000 | 7918 | 23,1 мс | 0,02% | 2532 |
Урок - у методі, а не в пропускній здатності. Конфіг A використовував proxy_pass зі змінною без блоку upstream, тож nginx відкривав нове TCP-з'єднання до API на кожен запит. Першим у ліміт CPU впирався проксі (cpu.stat: 1512 із 2787 періодів із тротлінгом при 0,25 CPU, а при 1,0 CPU стеля все одно близько 940 запитів/с), тоді як база використовувала значно менше половини свого ліміту. Конфіг B, upstream із keepalive 32, тримав проксі близько третини одного CPU на 8000 запитів/с. Наступні обмеження одразу проявилися в тих самих лічильниках: база мала тротлінг у 301 із 2790 періодів, а воркер із лімітом 0,25 CPU тротлився майже в кожному періоді й залишив у черзі 46 982 завдання (LLEN jobs). Набір даних 146 МБ вміщується в пам'ять, тож диска це не торкалося. Перевірка fio на тимчасовому файлі (fio --name=w --filename=fio.tmp --size=256M --rw=write --bs=8k --fdatasync=1 --ioengine=sync --runtime=15 --time_based) показала 700 синхронних записів на секунду, приблизно по 1,4 мс; прогін довільного читання (fio --name=r --filename=fio.tmp --size=256M --rw=randread --bs=4k --iodepth=32 --ioengine=libaio --direct=1 --runtime=15 --time_based) повідомив 399 000 IOPS - це кеш сторінок, а не диск.
Рахуємо ціну результату в конфігураторі
- Відкрийте сторінку хмарних серверів. Вона не зчитує числа з цієї статті, тож задайте їх самі: оберіть рядок плану, найближчий до вашого профілю (Small, Medium чи Large), потім підлаштуйте повзунки CPU (1-96), RAM (1-256 ГБ) і диска (20-960 ГБ) під значення з вашого аркуша.
- Додайте копії бекапу, додаткові адреси IPv4 і години адміністрування та дивіться повну місячну ціну, а не ціну "від". Кероване адміністрування починається від EUR 30 за дві години.
Перевірено за прайсом 2026-10-14: Medium із 3 бекапами - EUR 21.47, а той самий CPU із 16 ГБ RAM - EUR 29.95. Найбільше ціну змінює RAM.
Налаштувати хмарний сервер для вашого застосунку
Коли виносити базу даних або переходити на dedicated
- Виносьте БД, коли їй потрібно понад половину пам'яті VM, коли API та БД тротлять одна одну за CPU або коли потрібен окремий ритм відновлення. Див. посібник із PostgreSQL.
- Переходьте на dedicated, коли одне навантаження в пік тримає зайнятими понад 70% усіх vCPU, потребує більше за 96 vCPU чи 256 ГБ RAM, які дає хмарний сервер, або вимагає передбачуваної затримки диска. Див. виділені сервери.
Шаблон міграції та відкату
Спершу відрепетируйте його на новому сервері.
| Крок | Дія | Відкат |
|---|---|---|
| 1 | Відновіть свіжий дамп на новому сервері, запустіть застосунок і проженіть навантажувальний тест | видаліть новий сервер |
| 2 | Заморозьте запис, зробіть фінальний дамп, відновіть, порівняйте кількість рядків | знову відкрийте запис на старому сервері |
| 3 | Перемкніть DNS (TTL знижено до 300 с за повний старий TTL наперед), перевірте вхід, замовлення, завдання й пошту | поверніть DNS назад |
| 4 | Тримайте старий сервер у режимі читання щонайменше тиждень | відтворіть нові записи на старому боці |
Аркуш підбору ресурсів
Роздрукуйте його й заповніть праву колонку власними вимірами.
| Пункт | Як отримати | Ваше значення |
|---|---|---|
| Пікові запити за секунду | аналітика або навантажувальний тест | |
| Цільовий p95 і частка помилок | ваш SLO, наприклад 300 мс і 1% | |
| Процеси API | по одному на vCPU | |
| Ліміт пам'яті контейнера | піковий RSS під навантаженням плюс запас | |
| З'єднання з БД | пули x процеси, нижче max_connections |
|
| Вільна пам'ять | 20-25% VM | |
| Диск | дані та ріст + WAL + логи + образи + тимчасовий дамп, потім 20% вільного | |
| Бекапи | скільки копій, виміряний час відновлення | |
| Місячна ціна | підсумок конфігуратора з бекапами, IPv4, адмін-годинами, дата |
Відтворіть самі
Потрібні Docker із Compose, curl, openssl і vmstat; образ k6 завантажується під час першого запуску. Файли - ті самі, що ми запускали, із зазначеними версіями. Теги postgres:17-alpine, redis:7-alpine і node:22-alpine плаваючі, а npm install не має lock-файлу, тож зафіксуйте теги й версії, якщо потрібен той самий результат.
compose.yaml
# "Small production" starting hypothesis for a 4 vCPU / 8 GB VM: limits sum to 4.0 CPU and 3.2 GB
name: saas-sizing

x-logging: &logging
  driver: json-file
  options: { max-size: 10m, max-file: "3" }   # logs cannot fill the disk

services:
  proxy:
    build: { context: ., dockerfile: Dockerfile.proxy }
    ports: ["127.0.0.1:8080:80"]        # the only published port, loopback only
    depends_on:
      api: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1/healthz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "1.0", memory: 64M } } }
    logging: *logging
    restart: unless-stopped

  api:
    build: .
    command: ["node", "--max-old-space-size=192", "src/api.js"]
    env_file: [.env]
    environment:
      PG_POOL: "10"
    expose: ["3000"]
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000/readyz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy:
      replicas: 2
      resources: { limits: { cpus: "0.5", memory: 320M } }
    logging: *logging
    restart: unless-stopped

  worker:
    build: .
    command: ["node", "--max-old-space-size=128", "src/worker.js"]
    env_file: [.env]
    environment:
      PG_POOL: "3"
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD-SHELL", "pgrep -f src/worker.js >/dev/null"]
      interval: 15s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

  db:
    image: postgres:17-alpine
    env_file: [.env]
    command: [postgres,
      -c, shared_buffers=512MB, -c, effective_cache_size=1536MB,
      -c, work_mem=8MB, -c, maintenance_work_mem=128MB,
      -c, max_connections=50, -c, max_wal_size=1GB,
      -c, shared_preload_libraries=pg_stat_statements,
      -c, log_min_duration_statement=250, -c, track_io_timing=on]
    volumes: ["pgdata:/var/lib/postgresql/data"]
    # no "ports": reachable only from the compose network
    shm_size: 256m
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $$POSTGRES_USER -d $$POSTGRES_DB"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "1.5", memory: 2G } } }
    logging: *logging
    restart: unless-stopped

  redis:
    image: redis:7-alpine
    env_file: [.env]
    command: ["sh", "-c", "exec redis-server --requirepass \"$$REDIS_PASSWORD\" --maxmemory 128mb --maxmemory-policy noeviction --appendonly yes"]
    volumes: ["redisdata:/data"]
    healthcheck:
      test: ["CMD-SHELL", "REDISCLI_AUTH=\"$$REDIS_PASSWORD\" redis-cli ping | grep -q PONG"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

volumes:
  pgdata:
  redisdata:
Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package.json ./
RUN npm install --omit=dev --no-audit --no-fund
COPY src ./src
USER node
Dockerfile.proxy
FROM nginx:1.27-alpine
COPY nginx.conf /etc/nginx/nginx.conf
nginx.conf
worker_processes 1;
events { worker_connections 1024; }
http {
  access_log off;
  # resolved once at start: restart the proxy if the api containers get new addresses
  upstream api {
    server api:3000;
    keepalive 32;   # reuse upstream connections instead of one TCP connect per request
  }
  server {
    listen 80;
    location = /healthz { return 200 "ok\n"; }
    location / {
      proxy_pass http://api;
      proxy_http_version 1.1;
      proxy_set_header Connection "";
      proxy_set_header Host $host;
      proxy_read_timeout 10s;
    }
  }
}
package.json
{
  "name": "saas-sizing-example",
  "private": true,
  "type": "module",
  "dependencies": {
    "ioredis": "5.4.1",
    "pg": "8.13.1"
  }
}
src/db.js
import pg from 'pg'
import Redis from 'ioredis'

// pool size x processes must stay under Postgres max_connections (see the budget table)
export const pool = new pg.Pool({
  connectionString: process.env.DATABASE_URL,
  max: Number(process.env.PG_POOL || 10),
  statement_timeout: 5000,
})
export const redis = new Redis(process.env.REDIS_URL, { maxRetriesPerRequest: 2 })
src/api.js
import http from 'node:http'
import { pool, redis } from './db.js'

const json = (res, code, body) => {
  res.writeHead(code, { 'content-type': 'application/json' })
  res.end(JSON.stringify(body))
}
const readBody = req => new Promise((ok, fail) => {
  let s = ''
  req.on('data', c => { s += c; if (s.length > 4096) req.destroy() })
  req.on('end', () => ok(s))
  req.on('error', fail)
})

const routes = {
  'GET /healthz': (req, res) => json(res, 200, { ok: true }),
  // readiness touches both stores; the container healthcheck uses it
  'GET /readyz': async (req, res) => {
    await pool.query('select 1')
    await redis.ping()
    json(res, 200, { ok: true })
  },
  'GET /api/tasks': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select id, title, status from tasks where account_id = $1 order by id desc limit 20', [account])
    json(res, 200, rows)
  },
  'GET /api/report': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select status, count(*)::int as n from tasks where account_id = $1 group by status', [account])
    json(res, 200, rows)
  },
  'POST /api/tasks': async (req, res) => {
    let b
    try { b = JSON.parse(await readBody(req)) } catch { return json(res, 400, { error: 'json' }) }
    const account = Number(b.account)
    if (!Number.isInteger(account) || account < 1 || typeof b.title !== 'string' || b.title.length > 200) {
      return json(res, 400, { error: 'input' })
    }
    const { rows } = await pool.query(
      "insert into tasks (account_id, title) values ($1, $2) returning id", [account, b.title])
    await redis.lpush('jobs', String(rows[0].id))
    json(res, 201, { id: rows[0].id })
  },
}

const server = http.createServer(async (req, res) => {
  const url = new URL(req.url, 'http://x')
  const h = routes[`${req.method} ${url.pathname}`]
  if (!h) return json(res, 404, { error: 'not found' })
  try { await h(req, res, url) } catch (e) {
    console.error(e.message)
    json(res, 503, { error: 'unavailable' })
  }
})
server.listen(3000, () => console.log('api up'))

// compose sends SIGTERM on stop: finish in-flight requests, then close the stores
process.on('SIGTERM', () => server.close(async () => { await pool.end(); redis.disconnect(); process.exit(0) }))
src/worker.js
import { createHash } from 'node:crypto'
import { pool, redis } from './db.js'

let stop = false
process.on('SIGTERM', () => { stop = true })

// stands in for real background work (mail, PDF, webhook): a little CPU, then one UPDATE
const work = title => {
  let h = title
  for (let i = 0; i < 2000; i++) h = createHash('sha256').update(h).digest('hex')
  return h.slice(0, 16)
}

console.log('worker up')
while (!stop) {
  const r = await redis.brpop('jobs', 2)
  if (!r) continue
  const id = Number(r[1])
  const { rows } = await pool.query('select title from tasks where id = $1', [id])
  if (!rows.length) continue
  await pool.query("update tasks set status = 'done', result = $2 where id = $1", [id, work(rows[0].title)])
}
await pool.end()
redis.disconnect()
init.sql
create extension if not exists pg_stat_statements;
create table tasks (
  id bigserial primary key,
  account_id int not null,
  title text not null,
  status text not null default 'open',
  result text,
  created_at timestamptz not null default now()
);
create index tasks_account_id_idx on tasks (account_id, id desc);
seed.sql
-- 1,000,000 tasks for 2,000 accounts (about 500 each), 70% done
insert into tasks (account_id, title, status)
select 1 + (g % 2000), 'task ' || g, case when g % 10 < 7 then 'done' else 'open' end
from generate_series(1, 1000000) g;
analyze tasks;
make-env.sh
#!/bin/sh
# writes .env with random secrets; never commit it, and never reuse these values elsewhere
set -eu
[ -e .env ] && { echo ".env exists, not overwriting"; exit 1; }
PG=$(openssl rand -hex 24)
RD=$(openssl rand -hex 24)
umask 077
cat > .env <<EOF
POSTGRES_USER=app
POSTGRES_PASSWORD=$PG
POSTGRES_DB=app
REDIS_PASSWORD=$RD
DATABASE_URL=postgres://app:$PG@db:5432/app
REDIS_URL=redis://:$RD@redis:6379
EOF
k6.js
import http from 'k6/http'
import { check } from 'k6'

const BASE = __ENV.BASE || 'http://proxy'
const RATE = Number(__ENV.RATE || 100)

// open model: requests arrive at RATE per second whether or not the server keeps up,
// which is how real users behave (closed-loop VUs hide overload)
export const options = {
  scenarios: {
    mixed: {
      executor: 'constant-arrival-rate',
      rate: RATE,
      timeUnit: '1s',
      duration: __ENV.DURATION || '30s',
      preAllocatedVUs: 50,
      maxVUs: 500,
    },
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
  },
  summaryTrendStats: ['avg', 'med', 'p(90)', 'p(95)', 'p(99)', 'max'],
}

export default function () {
  const account = 1 + Math.floor(Math.random() * 2000)
  const r = Math.random()
  let res
  if (r < 0.80) res = http.get(`${BASE}/api/tasks?account=${account}`)
  else if (r < 0.90) res = http.get(`${BASE}/api/report?account=${account}`)
  else res = http.post(`${BASE}/api/tasks`, JSON.stringify({ account, title: 'k6 task' }),
    { headers: { 'content-type': 'application/json' } })
  check(res, { 'status 200/201': x => x.status === 200 || x.status === 201 })
}
bench.sh
#!/bin/sh
# usage: ./bench.sh 200 500 1000   (requests per second, one 40 s step each)
set -eu
NET=$(docker compose ps -q proxy | xargs docker inspect --format '{{range $k, $v := .NetworkSettings.Networks}}{{$k}}{{end}}')
for RATE in "$@"; do
  echo "=== ${RATE} req/s"
  # mid-run snapshot of container CPU / memory and host CPU steal ("st") and swap ("si so")
  ( sleep 20; docker stats --no-stream --format '{{.Name}} cpu={{.CPUPerc}} mem={{.MemUsage}}' $(docker compose ps -q); vmstat 5 2 | tail -1 ) &
  docker run --rm -i --network "$NET" -e RATE="$RATE" -e DURATION=40s \
    grafana/k6 run --quiet - < k6.js 2>&1 | grep -E 'http_req_duration\.|http_req_failed\.|http_reqs|dropped_iterations|vus_max'
  wait
done
sh make-env.sh
docker compose up -d --build
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < init.sql
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < seed.sql
curl -s http://127.0.0.1:8080/readyz
./bench.sh 500 1000
docker compose down -v
Ваші числа відрізнятимуться. Тоді довіряйте їм, а не нашим, і налаштуйте хмарний сервер під свій застосунок або напишіть на sales@dcxv.com.