SaaS-Cloud-Server dimensionieren: CPU, RAM, NVMe, Backups
Um einen Cloud-Server für eine SaaS-Anwendung zu dimensionieren, gehen Sie nicht von der Nutzerzahl aus. Beginnen Sie mit dem Speicher pro Prozess, legen Sie dann die CPU pro Container fest, planen Sie anschließend den Datenträger für Daten, WAL und Backups und prüfen Sie jede Annahme mit einem Lasttest. Diese Anleitung tut das an einem realen Beispiel: Node.js-API und -Worker, PostgreSQL, Redis und nginx in Docker Compose, getestet auf einer Maschine. Die Profile unten sind Startannahmen; einfache Startbereiche finden Sie im Dimensionierungsleitfaden.
Der Beispiel-Stack
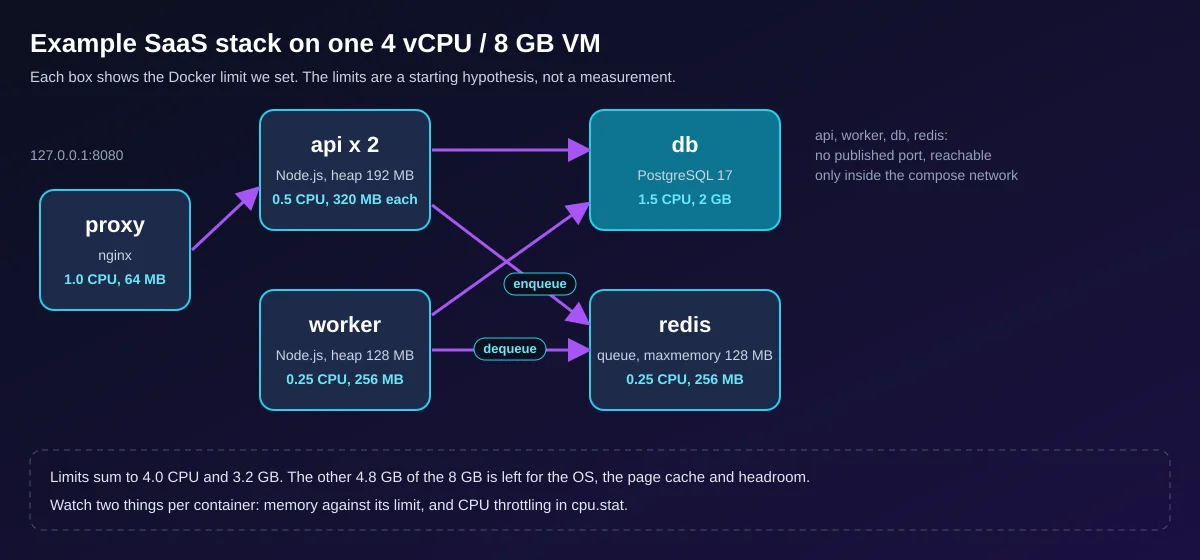
Das Beispiel ist eine API für Aufgabenverwaltung: ein nginx-Proxy, zwei Node.js-API-Replikate, ein Worker, der eine Redis-Queue abarbeitet, PostgreSQL 17 und Redis 7. Nur der Proxy veröffentlicht einen Port, und zwar auf Loopback. Die Secrets liegen in einer nicht eingecheckten .env-Datei, jeder Dienst hat einen Healthcheck und ein Ressourcenlimit, und die Logs rotieren. Monitoring heißt hier docker stats, cgroup-Zähler und pg_stat_statements. Zur Node.js-Seite allein siehe Cloud-Server für Node.js. Die vollständigen Dateien stehen am Ende.
Warum Nutzer sich nicht in vCPU umrechnen lassen
- Parallelität statt Köpfe - gleichzeitige Anfragen = Ankunftsrate x Zeit pro Anfrage (Littles Gesetz). 1000 Nutzer, die einmal pro Minute klicken, sind etwa 17 Anfragen pro Sekunde; ein Skript, das jede Sekunde abfragt, erzeugt dieselbe Last wie 60 dieser Nutzer.
- SQL-Kosten und Laufzeitmodell - in unserem Lauf brauchte die Report-Abfrage laut
pg_stat_statementsim Mittel 1,07 ms, die Listen-Abfrage 0,07 ms, also etwa das 15-Fache. Ein Node.js-Prozess nutzt etwa einen Kern, daher ist die vCPU-Zahl der API die Zahl der Prozesse, nicht der Nutzer. - Sockets, Jobs und Spitzen - ein offener WebSocket belegt Speicher für seine gesamte Lebensdauer, ein Hintergrundjob konkurriert mit Anfragen um dieselben Kerne, und dimensioniert wird für die lauteste Stunde, nicht für den Durchschnitt.
Drei Startprofile
Annahmen, keine Messungen. Die Preise sind Monatsbeträge für Prag, am 2026-10-14 aus der Preisliste nachgerechnet.
| Profil | Startspezifikation | Monatspreis, Grundlage |
|---|---|---|
| Dev / Staging | 2 vCPU, 4 GB RAM, 40 GB NVMe (Small) | EUR 15.00, 1 Backup |
| Kleine Produktion | 4 vCPU, 8 GB RAM, 80 GB NVMe (Medium), das Beispiel wie veröffentlicht | EUR 18.43, 1 Backup |
| Wachsendes SaaS, ein Server | 8 vCPU, 16 GB RAM, 160 GB NVMe (Large) | EUR 36.88, 1 Backup |
| Wachsendes SaaS, getrennt | Medium-Anwendungsserver plus Datenbankserver mit 4 vCPU, 16 GB RAM, 160 GB NVMe | EUR 18.43 (1 Backup) + EUR 39.05 (3 Backups) = EUR 57.48 |
Die Rechnung für Speicher, Datenträger und Backups
Die Limits unten setzt die Compose-Datei; die letzte Spalte zeigt den residenten Speicher, den docker stats bei unseren Laststufen über alle Läufe anzeigte.
| Container | Limit | Einstellung | Unter Last |
|---|---|---|---|
| proxy | 64 MB | nginx, ein Worker | 3-18 MB |
| api (x2) | je 320 MB | --max-old-space-size=192, Pool 10 |
je 21-34 MB |
| worker | 256 MB | Heap 128 MB, Pool 3 | 19-34 MB |
| db | 2 GB | shared_buffers 512 MB, work_mem 8 MB |
207-252 MB |
| redis | 256 MB | maxmemory 128 MB, keine Verdrängung |
4-7 MB |
Die Limits summieren sich auf 3,2 GB, sodass 4,8 GB der 8-GB-VM für das Betriebssystem und den Seitencache bleiben. Drei Regeln erzeugen die Zahlen. Erstens beginnt shared_buffers bei 25% des Speichers eines dedizierten Datenbankservers (PostgreSQL-Dokumentation, geprüft am 2026-10-14): 25% der 2 GB des Containers sind 512 MB. Zweitens gilt work_mem je Sortier- oder Hash-Operation, nicht je Verbindung, die Summe kann also ein Vielfaches des Werts betragen: 23 Anwendungsverbindungen mit 8 MB und je zwei solchen Operationen ergeben im schlechtesten Fall 368 MB. Drittens müssen Pools mal Prozesse (2 x 10 + 3 = 23) unter max_connections (50) bleiben.
Datenträger und Backups. Nach etwa 1,04 Millionen Zeilen war die Datenbank 146 MB groß, das Datenverzeichnis aber 457 MB, davon 288 MB pg_wal: Das WAL folgt max_wal_size (einer weichen Grenze), nicht der Datenmenge, also planen Sie es ein und halten Sie mehr als 20% des Datenträgers frei. Bei diesem winzigen Datensatz dauerte pg_dump -Fc 0,59 s (7 MB) und die Wiederherstellung 1,78 s; Ihre Wiederherstellungszeit ist Ihre Ausfallzeit, also messen Sie sie. Jeder DCXV-Cloud-Preis enthält ein wöchentliches Datenträger-Backup: eine Sicherheitskopie, kein Platz für Ihre Dateien.
Den Engpass mit k6 finden
Legen Sie zuerst die Bestehensbedingung fest (hier p95 unter 300 ms und weniger als 1% fehlgeschlagene Anfragen), nutzen Sie ein offenes Modell (constant-arrival-rate, siehe k6-Dokumentation), steigern Sie die Rate schrittweise und beobachten Sie gleichzeitig diese Signale.
| Signal | Befehl | Schlechtes Zeichen |
|---|---|---|
| p95, Fehler, verworfene Iterationen | k6-Zusammenfassung | p95 über dem Ziel, der Server hält die Ankunftsrate nicht |
| CPU-Throttling | grep nr_throttled /sys/fs/cgroup/cpu.stat im Container |
wächst während der Stufe (Kernel-Dokumentation) |
| CPU-Steal | vmstat 5, Spalte st |
über 0 auf einer VM: der Host ist ausgelastet |
| Speicherdruck | docker stats, vmstat Spalten si so |
nahe am Limit oder Swapping |
Gemessen auf einer 12-Kern-arm64-Linux-Maschine mit 14,4 GB RAM, Docker 29.7.2, k6 2.3.0, PostgreSQL 17.11, Node.js 22.23.3, nginx 1.27.5, Redis 7.4.11, am 2026-10-14, ein Lauf von 40 s je Stufe, sofern nicht zwei Werte stehen. Das ist nicht DCXV Cloud. k6 teilte sich die CPUs mit dem Stack, und der Host nutzte zudem Swap, die Latenzen sind also pessimistisch: Für einen echten Test starten Sie k6 von einer zweiten Maschine. "Verworfen" zählt Ankünfte, die k6 übersprang, weil alle 500 virtuellen Nutzer beschäftigt waren.
| nginx-Konfig | Angebotene Anfragen/s | Erreichte Anfragen/s | p95 | Fehlgeschlagen | Verworfen |
|---|---|---|---|---|---|
| A, Proxy 0,25 CPU | 1000 | 610 | 2,11 s | 0,03% | 15 595 |
| A, Proxy 1,0 CPU | 1000 | 994 und 997 | 150 ms und 51,5 ms | 0% | 207 und 121 |
| A, Proxy 1,0 CPU | 2000 | 941 | 1,77 s | 6,56% | 42 356 |
| B, Keepalive | 1000 | 999 und 1000 | 2,66 ms und 2,42 ms | 0% | 36 und 0 |
| B, Keepalive | 5000 | 4995 | 1,48 ms | 0% | 206 |
| B, Keepalive | 8000 | 7918 | 23,1 ms | 0,02% | 2532 |
Die Lehre ist die Methode, nicht der Durchsatz. Konfig A nutzte proxy_pass mit einer Variablen und ohne upstream-Block, sodass nginx für jede Anfrage eine neue TCP-Verbindung zur API öffnete. Der Proxy stieß zuerst an sein CPU-Limit (cpu.stat: 1512 von 2787 Perioden gedrosselt bei 0,25 CPU, bei 1,0 CPU weiterhin eine Obergrenze bei etwa 940 Anfragen/s), während die Datenbank deutlich weniger als die Hälfte ihres Limits nutzte. Konfig B, ein upstream mit keepalive 32, hielt den Proxy bei 8000 Anfragen/s auf etwa einem Drittel einer CPU. Die nächsten Grenzen zeigten sich danach in denselben Zählern: Die Datenbank wurde in 301 von 2790 Perioden gedrosselt, und der Worker mit 0,25 CPU wurde fast in jeder Periode gedrosselt und ließ 46 982 Jobs in der Queue zurück (LLEN jobs). Ein Datensatz von 146 MB passt in den Speicher, daher berührte nichts davon den Datenträger. Eine fio-Prüfung auf einer temporären Datei (fio --name=w --filename=fio.tmp --size=256M --rw=write --bs=8k --fdatasync=1 --ioengine=sync --runtime=15 --time_based) ergab 700 synchrone Schreibvorgänge pro Sekunde mit etwa 1,4 ms; ein Lauf mit zufälligem Lesen (fio --name=r --filename=fio.tmp --size=256M --rw=randread --bs=4k --iodepth=32 --ioengine=libaio --direct=1 --runtime=15 --time_based) meldete 399 000 IOPS, und das ist der Seitencache, nicht der Datenträger.
Das Ergebnis im Konfigurator bepreisen
- Öffnen Sie die Cloud-Server-Seite. Sie liest keine Zahlen aus diesem Artikel, stellen Sie sie also selbst ein: Wählen Sie die Planzeile, die Ihrem Profil am nächsten kommt (Small, Medium oder Large), und passen Sie dann die Regler für CPU (1-96), RAM (1-256 GB) und Datenträger (20-960 GB) an die Werte Ihres Arbeitsblatts an.
- Fügen Sie Backup-Kopien, zusätzliche IPv4-Adressen und Administrationsstunden hinzu und lesen Sie den vollen Monatspreis ab, nicht den Preis "ab". Verwaltete Administration beginnt bei EUR 30 für zwei Stunden.
Gegen die Preisliste am 2026-10-14 geprüft: Medium mit 3 Backups kostet EUR 21.47, dieselbe CPU mit 16 GB RAM EUR 29.95. Der RAM verändert den Preis am stärksten.
Cloud-Server für Ihre App konfigurieren
Wann Datenbank trennen oder Dedicated wählen
- DB trennen, wenn sie mehr als etwa die Hälfte des VM-Speichers braucht, wenn API und DB sich gegenseitig um CPU drosseln oder wenn Sie einen eigenen Wiederherstellungsrhythmus wollen. Siehe den PostgreSQL-Leitfaden.
- Dedicated wählen, wenn eine Last in der Spitze mehr als 70% aller vCPU belegt, mehr als die 96 vCPU oder 256 GB RAM eines Cloud-Servers braucht oder planbare Datenträger-Latenz verlangt. Siehe Dedicated Server.
Vorlage für Migration und Rollback
Proben Sie sie zuerst auf dem neuen Server.
| Schritt | Aktion | Rollback |
|---|---|---|
| 1 | Aktuellen Dump auf dem neuen Server einspielen, die App starten und einem Lasttest unterziehen | neuen Server löschen |
| 2 | Schreibzugriffe stoppen, finalen Dump ziehen, einspielen, Zeilenzahlen vergleichen | Schreibzugriffe auf dem alten Server wieder öffnen |
| 3 | DNS umstellen (TTL auf 300 s gesenkt, eine volle alte TTL im Voraus), Login, Bestellung, Job und Mail prüfen | DNS zurückstellen |
| 4 | Alten Server mindestens eine Woche schreibgeschützt behalten | neue Schreibvorgänge auf der alten Seite nachspielen |
Arbeitsblatt zur Dimensionierung
Drucken Sie es aus und füllen Sie die rechte Spalte mit Ihren eigenen Messungen.
| Posten | So ermitteln | Ihr Wert |
|---|---|---|
| Spitzen-Anfragen pro Sekunde | Analytics oder Lasttest | |
| Ziel-p95 und Fehlerquote | Ihr SLO, zum Beispiel 300 ms und 1% | |
| API-Prozesse | einer je vCPU | |
| Speicherlimit des Containers | Spitzen-RSS unter Last plus Reserve | |
| DB-Verbindungen | Pools x Prozesse, unter max_connections |
|
| Freier Speicher | 20-25% der VM | |
| Datenträger | Daten und Wachstum + WAL + Logs + Images + temporärer Dump, dann 20% frei | |
| Backups | Anzahl der Kopien, gemessene Wiederherstellungszeit | |
| Monatspreis | Summe im Konfigurator mit Backups, IPv4, Admin, Datum |
Selbst nachbauen
Sie brauchen Docker mit Compose, curl, openssl und vmstat; das k6-Image wird beim ersten Start geladen. Die Dateien sind die, die wir ausgeführt haben, mit diesen Versionen. Die Tags postgres:17-alpine, redis:7-alpine und node:22-alpine sind nicht festgelegt (sie wandern mit neuen Releases) und npm install hat keine Lockdatei, fixieren Sie also Tags und Versionen, wenn Sie dasselbe Ergebnis brauchen.
compose.yaml
# "Small production" starting hypothesis for a 4 vCPU / 8 GB VM: limits sum to 4.0 CPU and 3.2 GB
name: saas-sizing

x-logging: &logging
  driver: json-file
  options: { max-size: 10m, max-file: "3" }   # logs cannot fill the disk

services:
  proxy:
    build: { context: ., dockerfile: Dockerfile.proxy }
    ports: ["127.0.0.1:8080:80"]        # the only published port, loopback only
    depends_on:
      api: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1/healthz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "1.0", memory: 64M } } }
    logging: *logging
    restart: unless-stopped

  api:
    build: .
    command: ["node", "--max-old-space-size=192", "src/api.js"]
    env_file: [.env]
    environment:
      PG_POOL: "10"
    expose: ["3000"]
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000/readyz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy:
      replicas: 2
      resources: { limits: { cpus: "0.5", memory: 320M } }
    logging: *logging
    restart: unless-stopped

  worker:
    build: .
    command: ["node", "--max-old-space-size=128", "src/worker.js"]
    env_file: [.env]
    environment:
      PG_POOL: "3"
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD-SHELL", "pgrep -f src/worker.js >/dev/null"]
      interval: 15s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

  db:
    image: postgres:17-alpine
    env_file: [.env]
    command: [postgres,
      -c, shared_buffers=512MB, -c, effective_cache_size=1536MB,
      -c, work_mem=8MB, -c, maintenance_work_mem=128MB,
      -c, max_connections=50, -c, max_wal_size=1GB,
      -c, shared_preload_libraries=pg_stat_statements,
      -c, log_min_duration_statement=250, -c, track_io_timing=on]
    volumes: ["pgdata:/var/lib/postgresql/data"]
    # no "ports": reachable only from the compose network
    shm_size: 256m
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $$POSTGRES_USER -d $$POSTGRES_DB"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "1.5", memory: 2G } } }
    logging: *logging
    restart: unless-stopped

  redis:
    image: redis:7-alpine
    env_file: [.env]
    command: ["sh", "-c", "exec redis-server --requirepass \"$$REDIS_PASSWORD\" --maxmemory 128mb --maxmemory-policy noeviction --appendonly yes"]
    volumes: ["redisdata:/data"]
    healthcheck:
      test: ["CMD-SHELL", "REDISCLI_AUTH=\"$$REDIS_PASSWORD\" redis-cli ping | grep -q PONG"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

volumes:
  pgdata:
  redisdata:
Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package.json ./
RUN npm install --omit=dev --no-audit --no-fund
COPY src ./src
USER node
Dockerfile.proxy
FROM nginx:1.27-alpine
COPY nginx.conf /etc/nginx/nginx.conf
nginx.conf
worker_processes 1;
events { worker_connections 1024; }
http {
  access_log off;
  # resolved once at start: restart the proxy if the api containers get new addresses
  upstream api {
    server api:3000;
    keepalive 32;   # reuse upstream connections instead of one TCP connect per request
  }
  server {
    listen 80;
    location = /healthz { return 200 "ok\n"; }
    location / {
      proxy_pass http://api;
      proxy_http_version 1.1;
      proxy_set_header Connection "";
      proxy_set_header Host $host;
      proxy_read_timeout 10s;
    }
  }
}
package.json
{
  "name": "saas-sizing-example",
  "private": true,
  "type": "module",
  "dependencies": {
    "ioredis": "5.4.1",
    "pg": "8.13.1"
  }
}
src/db.js
import pg from 'pg'
import Redis from 'ioredis'

// pool size x processes must stay under Postgres max_connections (see the budget table)
export const pool = new pg.Pool({
  connectionString: process.env.DATABASE_URL,
  max: Number(process.env.PG_POOL || 10),
  statement_timeout: 5000,
})
export const redis = new Redis(process.env.REDIS_URL, { maxRetriesPerRequest: 2 })
src/api.js
import http from 'node:http'
import { pool, redis } from './db.js'

const json = (res, code, body) => {
  res.writeHead(code, { 'content-type': 'application/json' })
  res.end(JSON.stringify(body))
}
const readBody = req => new Promise((ok, fail) => {
  let s = ''
  req.on('data', c => { s += c; if (s.length > 4096) req.destroy() })
  req.on('end', () => ok(s))
  req.on('error', fail)
})

const routes = {
  'GET /healthz': (req, res) => json(res, 200, { ok: true }),
  // readiness touches both stores; the container healthcheck uses it
  'GET /readyz': async (req, res) => {
    await pool.query('select 1')
    await redis.ping()
    json(res, 200, { ok: true })
  },
  'GET /api/tasks': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select id, title, status from tasks where account_id = $1 order by id desc limit 20', [account])
    json(res, 200, rows)
  },
  'GET /api/report': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select status, count(*)::int as n from tasks where account_id = $1 group by status', [account])
    json(res, 200, rows)
  },
  'POST /api/tasks': async (req, res) => {
    let b
    try { b = JSON.parse(await readBody(req)) } catch { return json(res, 400, { error: 'json' }) }
    const account = Number(b.account)
    if (!Number.isInteger(account) || account < 1 || typeof b.title !== 'string' || b.title.length > 200) {
      return json(res, 400, { error: 'input' })
    }
    const { rows } = await pool.query(
      "insert into tasks (account_id, title) values ($1, $2) returning id", [account, b.title])
    await redis.lpush('jobs', String(rows[0].id))
    json(res, 201, { id: rows[0].id })
  },
}

const server = http.createServer(async (req, res) => {
  const url = new URL(req.url, 'http://x')
  const h = routes[`${req.method} ${url.pathname}`]
  if (!h) return json(res, 404, { error: 'not found' })
  try { await h(req, res, url) } catch (e) {
    console.error(e.message)
    json(res, 503, { error: 'unavailable' })
  }
})
server.listen(3000, () => console.log('api up'))

// compose sends SIGTERM on stop: finish in-flight requests, then close the stores
process.on('SIGTERM', () => server.close(async () => { await pool.end(); redis.disconnect(); process.exit(0) }))
src/worker.js
import { createHash } from 'node:crypto'
import { pool, redis } from './db.js'

let stop = false
process.on('SIGTERM', () => { stop = true })

// stands in for real background work (mail, PDF, webhook): a little CPU, then one UPDATE
const work = title => {
  let h = title
  for (let i = 0; i < 2000; i++) h = createHash('sha256').update(h).digest('hex')
  return h.slice(0, 16)
}

console.log('worker up')
while (!stop) {
  const r = await redis.brpop('jobs', 2)
  if (!r) continue
  const id = Number(r[1])
  const { rows } = await pool.query('select title from tasks where id = $1', [id])
  if (!rows.length) continue
  await pool.query("update tasks set status = 'done', result = $2 where id = $1", [id, work(rows[0].title)])
}
await pool.end()
redis.disconnect()
init.sql
create extension if not exists pg_stat_statements;
create table tasks (
  id bigserial primary key,
  account_id int not null,
  title text not null,
  status text not null default 'open',
  result text,
  created_at timestamptz not null default now()
);
create index tasks_account_id_idx on tasks (account_id, id desc);
seed.sql
-- 1,000,000 tasks for 2,000 accounts (about 500 each), 70% done
insert into tasks (account_id, title, status)
select 1 + (g % 2000), 'task ' || g, case when g % 10 < 7 then 'done' else 'open' end
from generate_series(1, 1000000) g;
analyze tasks;
make-env.sh
#!/bin/sh
# writes .env with random secrets; never commit it, and never reuse these values elsewhere
set -eu
[ -e .env ] && { echo ".env exists, not overwriting"; exit 1; }
PG=$(openssl rand -hex 24)
RD=$(openssl rand -hex 24)
umask 077
cat > .env <<EOF
POSTGRES_USER=app
POSTGRES_PASSWORD=$PG
POSTGRES_DB=app
REDIS_PASSWORD=$RD
DATABASE_URL=postgres://app:$PG@db:5432/app
REDIS_URL=redis://:$RD@redis:6379
EOF
k6.js
import http from 'k6/http'
import { check } from 'k6'

const BASE = __ENV.BASE || 'http://proxy'
const RATE = Number(__ENV.RATE || 100)

// open model: requests arrive at RATE per second whether or not the server keeps up,
// which is how real users behave (closed-loop VUs hide overload)
export const options = {
  scenarios: {
    mixed: {
      executor: 'constant-arrival-rate',
      rate: RATE,
      timeUnit: '1s',
      duration: __ENV.DURATION || '30s',
      preAllocatedVUs: 50,
      maxVUs: 500,
    },
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
  },
  summaryTrendStats: ['avg', 'med', 'p(90)', 'p(95)', 'p(99)', 'max'],
}

export default function () {
  const account = 1 + Math.floor(Math.random() * 2000)
  const r = Math.random()
  let res
  if (r < 0.80) res = http.get(`${BASE}/api/tasks?account=${account}`)
  else if (r < 0.90) res = http.get(`${BASE}/api/report?account=${account}`)
  else res = http.post(`${BASE}/api/tasks`, JSON.stringify({ account, title: 'k6 task' }),
    { headers: { 'content-type': 'application/json' } })
  check(res, { 'status 200/201': x => x.status === 200 || x.status === 201 })
}
bench.sh
#!/bin/sh
# usage: ./bench.sh 200 500 1000   (requests per second, one 40 s step each)
set -eu
NET=$(docker compose ps -q proxy | xargs docker inspect --format '{{range $k, $v := .NetworkSettings.Networks}}{{$k}}{{end}}')
for RATE in "$@"; do
  echo "=== ${RATE} req/s"
  # mid-run snapshot of container CPU / memory and host CPU steal ("st") and swap ("si so")
  ( sleep 20; docker stats --no-stream --format '{{.Name}} cpu={{.CPUPerc}} mem={{.MemUsage}}' $(docker compose ps -q); vmstat 5 2 | tail -1 ) &
  docker run --rm -i --network "$NET" -e RATE="$RATE" -e DURATION=40s \
    grafana/k6 run --quiet - < k6.js 2>&1 | grep -E 'http_req_duration\.|http_req_failed\.|http_reqs|dropped_iterations|vus_max'
  wait
done
sh make-env.sh
docker compose up -d --build
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < init.sql
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < seed.sql
curl -s http://127.0.0.1:8080/readyz
./bench.sh 500 1000
docker compose down -v
Ihre Zahlen werden abweichen. Vertrauen Sie dann Ihren, nicht unseren, und konfigurieren Sie einen Cloud-Server für Ihre App oder schreiben Sie an sales@dcxv.com.