Cómo dimensionar un servidor cloud para SaaS: CPU, RAM, NVMe
Para dimensionar un servidor cloud para una aplicación SaaS, no partas del número de usuarios. Empieza por la memoria de cada proceso, sigue con la CPU de cada contenedor, después calcula el disco para datos, WAL y copias de seguridad, y comprueba cada suposición con una prueba de carga. Esta guía lo hace con un ejemplo real: API y worker en Node.js, PostgreSQL, Redis y nginx con Docker Compose, probados en una sola máquina. Los perfiles de abajo son hipótesis de partida; para rangos iniciales sencillos consulta la guía de dimensionamiento.
El stack del ejemplo
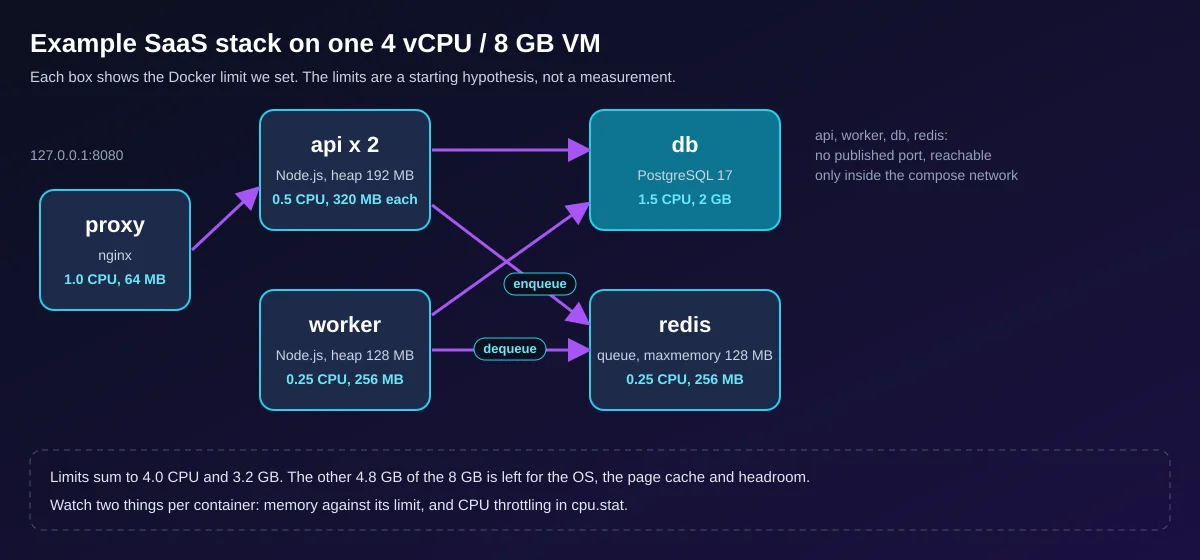
El ejemplo es una API de gestión de tareas: un proxy nginx, dos réplicas de la API en Node.js, un worker que vacía una cola de Redis, PostgreSQL 17 y Redis 7. Solo el proxy publica un puerto, y lo hace en loopback. Los secretos están en un archivo .env que no se sube al repositorio, cada servicio tiene un healthcheck y un límite de recursos, y los logs rotan. La monitorización aquí es docker stats, los contadores de cgroup y pg_stat_statements. Para la parte de Node.js por separado consulta Servidor Cloud para Node.js. Los archivos completos están al final.
Por qué los usuarios no se convierten en vCPU
- Concurrencia, no número de personas - solicitudes en curso = tasa de llegada x tiempo por solicitud (ley de Little). 1000 usuarios que hacen clic una vez por minuto son unas 17 solicitudes por segundo; un script que consulta cada segundo genera la misma carga que 60 de esos usuarios.
- Coste del SQL y modelo de ejecución - en nuestra prueba la consulta del informe tardó de media 1,07 ms en
pg_stat_statementsy la del listado 0,07 ms, unas 15 veces más. Un proceso de Node.js usa aproximadamente un núcleo, así que las vCPU de la API son el número de procesos, no de usuarios. - Sockets, tareas y picos - un WebSocket abierto retiene memoria durante toda su vida, una tarea en segundo plano compite con las solicitudes por los mismos núcleos, y se dimensiona para la hora más cargada, no para la media.
Tres perfiles de partida
Hipótesis, no mediciones. Los precios son importes mensuales para Praga, recalculados con la tarifa el 2026-10-14.
| Perfil | Especificación inicial | Precio mensual, base |
|---|---|---|
| Dev / staging | 2 vCPU, 4 GB de RAM, 40 GB NVMe (Small) | EUR 15.00, 1 copia |
| Producción pequeña | 4 vCPU, 8 GB de RAM, 80 GB NVMe (Medium), el ejemplo tal como se publica | EUR 18.43, 1 copia |
| SaaS en crecimiento, un servidor | 8 vCPU, 16 GB de RAM, 160 GB NVMe (Large) | EUR 36.88, 1 copia |
| SaaS en crecimiento, dividido | servidor de aplicación Medium más un servidor de base de datos de 4 vCPU, 16 GB de RAM, 160 GB NVMe | EUR 18.43 (1 copia) + EUR 39.05 (3 copias) = EUR 57.48 |
La aritmética de memoria, disco y copias
Los límites de abajo los fija el archivo compose; la última columna es la memoria residente que mostró docker stats durante nuestros escalones de carga, en todas las pruebas.
| Contenedor | Límite | Ajuste | Bajo carga |
|---|---|---|---|
| proxy | 64 MB | nginx, un worker | 3-18 MB |
| api (x2) | 320 MB cada uno | --max-old-space-size=192, pool de 10 |
21-34 MB cada uno |
| worker | 256 MB | heap 128 MB, pool de 3 | 19-34 MB |
| db | 2 GB | shared_buffers 512 MB, work_mem 8 MB |
207-252 MB |
| redis | 256 MB | maxmemory 128 MB, sin expulsión |
4-7 MB |
Los límites suman 3,2 GB, de modo que quedan 4,8 GB de los 8 GB de la VM para el sistema operativo y la caché de páginas. Tres reglas producen las cifras. Primera, shared_buffers empieza en el 25% de la memoria de un servidor de base de datos dedicado (documentación de PostgreSQL, comprobada el 2026-10-14): el 25% de los 2 GB del contenedor son 512 MB. Segunda, work_mem se aplica por operación de ordenación o hash, no por conexión, así que el total puede ser muchas veces el valor: 23 conexiones de la aplicación a 8 MB con dos operaciones así cada una dan un peor caso de 368 MB. Tercera, los pools multiplicados por los procesos (2 x 10 + 3 = 23) deben quedar por debajo de max_connections (50).
Disco y copias. Tras unos 1,04 millones de filas la base de datos ocupaba 146 MB, pero el directorio de datos 457 MB, de los que 288 MB eran pg_wal: el WAL sigue a max_wal_size (un límite blando), no al tamaño de los datos, así que presupuéstalo y deja libre más del 20% del disco. Con este conjunto de datos diminuto, pg_dump -Fc tardó 0,59 s (7 MB) y la restauración 1,78 s; tu tiempo de restauración es tu tiempo de caída, así que mídelo. Cada precio de DCXV Cloud incluye una copia semanal del disco: es una copia de seguridad, no espacio para tus archivos.
Encuentra el cuello de botella con k6
Fija primero la condición de éxito (aquí, p95 por debajo de 300 ms y menos del 1% de solicitudes fallidas), usa un modelo abierto (constant-arrival-rate, consulta la documentación de k6), sube la tasa por escalones y vigila estas señales a la vez.
| Señal | Comando | Mala señal |
|---|---|---|
| p95, errores, iteraciones descartadas | resumen de k6 | p95 por encima del objetivo, el servidor no sigue la tasa de llegada |
| Throttling de CPU | grep nr_throttled /sys/fs/cgroup/cpu.stat dentro del contenedor |
crece durante el escalón (documentación del kernel) |
| CPU steal | vmstat 5, columna st |
por encima de 0 en una VM: el host está saturado |
| Presión de memoria | docker stats, vmstat columnas si so |
cerca del límite o con swap |
Medido en una máquina Linux arm64 de 12 núcleos con 14,4 GB de RAM, Docker 29.7.2, k6 2.3.0, PostgreSQL 17.11, Node.js 22.23.3, nginx 1.27.5, Redis 7.4.11, el 2026-10-14, una ejecución de 40 s por escalón salvo que se muestren dos valores. No es DCXV Cloud. k6 compartió las CPU con el stack, y el host además usaba swap, así que las latencias son pesimistas: para una prueba real ejecuta k6 desde una segunda máquina. "Descartadas" cuenta las llegadas que k6 omitió porque los 500 usuarios virtuales estaban ocupados.
| Config. de nginx | Solicitudes/s ofrecidas | Solicitudes/s logradas | p95 | Fallidas | Descartadas |
|---|---|---|---|---|---|
| A, proxy 0,25 CPU | 1000 | 610 | 2,11 s | 0,03% | 15 595 |
| A, proxy 1,0 CPU | 1000 | 994 y 997 | 150 ms y 51,5 ms | 0% | 207 y 121 |
| A, proxy 1,0 CPU | 2000 | 941 | 1,77 s | 6,56% | 42 356 |
| B, keepalive | 1000 | 999 y 1000 | 2,66 ms y 2,42 ms | 0% | 36 y 0 |
| B, keepalive | 5000 | 4995 | 1,48 ms | 0% | 206 |
| B, keepalive | 8000 | 7918 | 23,1 ms | 0,02% | 2532 |
La lección es el método, no el rendimiento. La config. A usaba proxy_pass con una variable y sin bloque upstream, así que nginx abría una conexión TCP nueva hacia la API en cada solicitud. El proxy llegó primero a su límite de CPU (cpu.stat: 1512 de 2787 periodos con throttling con 0,25 CPU, y con 1,0 CPU seguía habiendo un tope cerca de 940 solicitudes/s) mientras la base de datos usaba bastante menos de la mitad de su límite. La config. B, un upstream con keepalive 32, mantuvo el proxy en cerca de un tercio de una CPU a 8000 solicitudes/s. Los siguientes límites aparecieron entonces en los mismos contadores: la base de datos tuvo throttling en 301 de 2790 periodos, y el worker de 0,25 CPU lo tuvo casi en todos los periodos y dejó 46 982 trabajos en la cola (LLEN jobs). Un conjunto de datos de 146 MB cabe en memoria, por lo que nada de esto tocó el disco. Una comprobación con fio sobre un archivo temporal (fio --name=w --filename=fio.tmp --size=256M --rw=write --bs=8k --fdatasync=1 --ioengine=sync --runtime=15 --time_based) midió 700 escrituras síncronas por segundo, de unos 1,4 ms; una ejecución de lectura aleatoria (fio --name=r --filename=fio.tmp --size=256M --rw=randread --bs=4k --iodepth=32 --ioengine=libaio --direct=1 --runtime=15 --time_based) informó 399 000 IOPS, que es la caché de páginas y no el disco.
Calcula el precio del resultado en el configurador
- Abre la página de servidores cloud. No lee cifras de este artículo, así que ajústalas tú: elige la fila de plan más cercana a tu perfil (Small, Medium o Large) y ajusta después los controles deslizantes de CPU (1-96), RAM (1-256 GB) y disco (20-960 GB) a los valores de tu hoja de trabajo.
- Añade copias de seguridad, direcciones IPv4 adicionales y horas de administración, y lee el precio mensual completo, no el precio "desde". La administración gestionada empieza en EUR 30 por dos horas.
Comprobado con la tarifa el 2026-10-14: Medium con 3 copias cuesta EUR 21.47, y la misma CPU con 16 GB de RAM, EUR 29.95. La RAM es lo que más mueve el precio.
Configura un servidor cloud para tu aplicación
Cuándo separar la base de datos o pasar a dedicado
- Separa la BD cuando necesite más de la mitad de la memoria de la VM, cuando API y BD entren en throttling mutuo por la CPU o cuando quieras un ritmo propio de restauración. Consulta la guía de PostgreSQL.
- Pasa a dedicado cuando una carga mantenga ocupadas más del 70% de todas las vCPU en el pico, necesite más de las 96 vCPU o 256 GB de RAM de un servidor cloud o requiera una latencia de disco predecible. Consulta los servidores dedicados.
Plantilla de migración y reversión
Ensáyala primero en el servidor nuevo.
| Paso | Acción | Reversión |
|---|---|---|
| 1 | Restaura un volcado reciente en el servidor nuevo, arranca la app y pásale una prueba de carga | elimina el servidor nuevo |
| 2 | Congela las escrituras, haz el volcado final, restáuralo y compara el número de filas | reabre las escrituras en el servidor antiguo |
| 3 | Cambia el DNS (TTL bajado a 300 s con un TTL antiguo completo de antelación) y prueba el inicio de sesión, el pedido, la tarea y el correo | devuelve el DNS al origen |
| 4 | Mantén el servidor antiguo en solo lectura al menos una semana | reproduce las escrituras nuevas en el lado antiguo |
Hoja de trabajo de dimensionamiento
Imprímela y rellena la columna derecha con tus propias mediciones.
| Concepto | Cómo obtenerlo | Tu valor |
|---|---|---|
| Solicitudes por segundo en el pico | analítica o prueba de carga | |
| p95 objetivo y tasa de fallos | tu SLO, por ejemplo 300 ms y 1% | |
| Procesos de API | uno por vCPU | |
| Límite de memoria del contenedor | RSS pico bajo carga más margen | |
| Conexiones a la BD | pools x procesos, por debajo de max_connections |
|
| Memoria libre | 20-25% de la VM | |
| Disco | datos y crecimiento + WAL + logs + imágenes + volcado temporal, y 20% libre | |
| Copias | cuántas se conservan, tiempo de restauración medido | |
| Precio mensual | total del configurador con copias, IPv4, administración y fecha |
Reprodúcelo
Necesitas Docker con Compose, curl, openssl y vmstat; la imagen de k6 se descarga en la primera ejecución. Los archivos son los que ejecutamos, con estas versiones. Las etiquetas postgres:17-alpine, redis:7-alpine y node:22-alpine son flotantes y npm install no tiene archivo de bloqueo, así que fija etiquetas y versiones si necesitas el mismo resultado.
compose.yaml
# "Small production" starting hypothesis for a 4 vCPU / 8 GB VM: limits sum to 4.0 CPU and 3.2 GB
name: saas-sizing

x-logging: &logging
  driver: json-file
  options: { max-size: 10m, max-file: "3" }   # logs cannot fill the disk

services:
  proxy:
    build: { context: ., dockerfile: Dockerfile.proxy }
    ports: ["127.0.0.1:8080:80"]        # the only published port, loopback only
    depends_on:
      api: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1/healthz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "1.0", memory: 64M } } }
    logging: *logging
    restart: unless-stopped

  api:
    build: .
    command: ["node", "--max-old-space-size=192", "src/api.js"]
    env_file: [.env]
    environment:
      PG_POOL: "10"
    expose: ["3000"]
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD", "wget", "-qO-", "http://127.0.0.1:3000/readyz"]
      interval: 10s
      timeout: 3s
      retries: 3
    deploy:
      replicas: 2
      resources: { limits: { cpus: "0.5", memory: 320M } }
    logging: *logging
    restart: unless-stopped

  worker:
    build: .
    command: ["node", "--max-old-space-size=128", "src/worker.js"]
    env_file: [.env]
    environment:
      PG_POOL: "3"
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_healthy }
    healthcheck:
      test: ["CMD-SHELL", "pgrep -f src/worker.js >/dev/null"]
      interval: 15s
      timeout: 3s
      retries: 3
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

  db:
    image: postgres:17-alpine
    env_file: [.env]
    command: [postgres,
      -c, shared_buffers=512MB, -c, effective_cache_size=1536MB,
      -c, work_mem=8MB, -c, maintenance_work_mem=128MB,
      -c, max_connections=50, -c, max_wal_size=1GB,
      -c, shared_preload_libraries=pg_stat_statements,
      -c, log_min_duration_statement=250, -c, track_io_timing=on]
    volumes: ["pgdata:/var/lib/postgresql/data"]
    # no "ports": reachable only from the compose network
    shm_size: 256m
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U $$POSTGRES_USER -d $$POSTGRES_DB"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "1.5", memory: 2G } } }
    logging: *logging
    restart: unless-stopped

  redis:
    image: redis:7-alpine
    env_file: [.env]
    command: ["sh", "-c", "exec redis-server --requirepass \"$$REDIS_PASSWORD\" --maxmemory 128mb --maxmemory-policy noeviction --appendonly yes"]
    volumes: ["redisdata:/data"]
    healthcheck:
      test: ["CMD-SHELL", "REDISCLI_AUTH=\"$$REDIS_PASSWORD\" redis-cli ping | grep -q PONG"]
      interval: 10s
      timeout: 3s
      retries: 5
    deploy: { resources: { limits: { cpus: "0.25", memory: 256M } } }
    logging: *logging
    restart: unless-stopped

volumes:
  pgdata:
  redisdata:
Dockerfile
FROM node:22-alpine
WORKDIR /app
COPY package.json ./
RUN npm install --omit=dev --no-audit --no-fund
COPY src ./src
USER node
Dockerfile.proxy
FROM nginx:1.27-alpine
COPY nginx.conf /etc/nginx/nginx.conf
nginx.conf
worker_processes 1;
events { worker_connections 1024; }
http {
  access_log off;
  # resolved once at start: restart the proxy if the api containers get new addresses
  upstream api {
    server api:3000;
    keepalive 32;   # reuse upstream connections instead of one TCP connect per request
  }
  server {
    listen 80;
    location = /healthz { return 200 "ok\n"; }
    location / {
      proxy_pass http://api;
      proxy_http_version 1.1;
      proxy_set_header Connection "";
      proxy_set_header Host $host;
      proxy_read_timeout 10s;
    }
  }
}
package.json
{
  "name": "saas-sizing-example",
  "private": true,
  "type": "module",
  "dependencies": {
    "ioredis": "5.4.1",
    "pg": "8.13.1"
  }
}
src/db.js
import pg from 'pg'
import Redis from 'ioredis'

// pool size x processes must stay under Postgres max_connections (see the budget table)
export const pool = new pg.Pool({
  connectionString: process.env.DATABASE_URL,
  max: Number(process.env.PG_POOL || 10),
  statement_timeout: 5000,
})
export const redis = new Redis(process.env.REDIS_URL, { maxRetriesPerRequest: 2 })
src/api.js
import http from 'node:http'
import { pool, redis } from './db.js'

const json = (res, code, body) => {
  res.writeHead(code, { 'content-type': 'application/json' })
  res.end(JSON.stringify(body))
}
const readBody = req => new Promise((ok, fail) => {
  let s = ''
  req.on('data', c => { s += c; if (s.length > 4096) req.destroy() })
  req.on('end', () => ok(s))
  req.on('error', fail)
})

const routes = {
  'GET /healthz': (req, res) => json(res, 200, { ok: true }),
  // readiness touches both stores; the container healthcheck uses it
  'GET /readyz': async (req, res) => {
    await pool.query('select 1')
    await redis.ping()
    json(res, 200, { ok: true })
  },
  'GET /api/tasks': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select id, title, status from tasks where account_id = $1 order by id desc limit 20', [account])
    json(res, 200, rows)
  },
  'GET /api/report': async (req, res, url) => {
    const account = Number(url.searchParams.get('account'))
    if (!Number.isInteger(account) || account < 1) return json(res, 400, { error: 'account' })
    const { rows } = await pool.query(
      'select status, count(*)::int as n from tasks where account_id = $1 group by status', [account])
    json(res, 200, rows)
  },
  'POST /api/tasks': async (req, res) => {
    let b
    try { b = JSON.parse(await readBody(req)) } catch { return json(res, 400, { error: 'json' }) }
    const account = Number(b.account)
    if (!Number.isInteger(account) || account < 1 || typeof b.title !== 'string' || b.title.length > 200) {
      return json(res, 400, { error: 'input' })
    }
    const { rows } = await pool.query(
      "insert into tasks (account_id, title) values ($1, $2) returning id", [account, b.title])
    await redis.lpush('jobs', String(rows[0].id))
    json(res, 201, { id: rows[0].id })
  },
}

const server = http.createServer(async (req, res) => {
  const url = new URL(req.url, 'http://x')
  const h = routes[`${req.method} ${url.pathname}`]
  if (!h) return json(res, 404, { error: 'not found' })
  try { await h(req, res, url) } catch (e) {
    console.error(e.message)
    json(res, 503, { error: 'unavailable' })
  }
})
server.listen(3000, () => console.log('api up'))

// compose sends SIGTERM on stop: finish in-flight requests, then close the stores
process.on('SIGTERM', () => server.close(async () => { await pool.end(); redis.disconnect(); process.exit(0) }))
src/worker.js
import { createHash } from 'node:crypto'
import { pool, redis } from './db.js'

let stop = false
process.on('SIGTERM', () => { stop = true })

// stands in for real background work (mail, PDF, webhook): a little CPU, then one UPDATE
const work = title => {
  let h = title
  for (let i = 0; i < 2000; i++) h = createHash('sha256').update(h).digest('hex')
  return h.slice(0, 16)
}

console.log('worker up')
while (!stop) {
  const r = await redis.brpop('jobs', 2)
  if (!r) continue
  const id = Number(r[1])
  const { rows } = await pool.query('select title from tasks where id = $1', [id])
  if (!rows.length) continue
  await pool.query("update tasks set status = 'done', result = $2 where id = $1", [id, work(rows[0].title)])
}
await pool.end()
redis.disconnect()
init.sql
create extension if not exists pg_stat_statements;
create table tasks (
  id bigserial primary key,
  account_id int not null,
  title text not null,
  status text not null default 'open',
  result text,
  created_at timestamptz not null default now()
);
create index tasks_account_id_idx on tasks (account_id, id desc);
seed.sql
-- 1,000,000 tasks for 2,000 accounts (about 500 each), 70% done
insert into tasks (account_id, title, status)
select 1 + (g % 2000), 'task ' || g, case when g % 10 < 7 then 'done' else 'open' end
from generate_series(1, 1000000) g;
analyze tasks;
make-env.sh
#!/bin/sh
# writes .env with random secrets; never commit it, and never reuse these values elsewhere
set -eu
[ -e .env ] && { echo ".env exists, not overwriting"; exit 1; }
PG=$(openssl rand -hex 24)
RD=$(openssl rand -hex 24)
umask 077
cat > .env <<EOF
POSTGRES_USER=app
POSTGRES_PASSWORD=$PG
POSTGRES_DB=app
REDIS_PASSWORD=$RD
DATABASE_URL=postgres://app:$PG@db:5432/app
REDIS_URL=redis://:$RD@redis:6379
EOF
k6.js
import http from 'k6/http'
import { check } from 'k6'

const BASE = __ENV.BASE || 'http://proxy'
const RATE = Number(__ENV.RATE || 100)

// open model: requests arrive at RATE per second whether or not the server keeps up,
// which is how real users behave (closed-loop VUs hide overload)
export const options = {
  scenarios: {
    mixed: {
      executor: 'constant-arrival-rate',
      rate: RATE,
      timeUnit: '1s',
      duration: __ENV.DURATION || '30s',
      preAllocatedVUs: 50,
      maxVUs: 500,
    },
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(95)<300'],
  },
  summaryTrendStats: ['avg', 'med', 'p(90)', 'p(95)', 'p(99)', 'max'],
}

export default function () {
  const account = 1 + Math.floor(Math.random() * 2000)
  const r = Math.random()
  let res
  if (r < 0.80) res = http.get(`${BASE}/api/tasks?account=${account}`)
  else if (r < 0.90) res = http.get(`${BASE}/api/report?account=${account}`)
  else res = http.post(`${BASE}/api/tasks`, JSON.stringify({ account, title: 'k6 task' }),
    { headers: { 'content-type': 'application/json' } })
  check(res, { 'status 200/201': x => x.status === 200 || x.status === 201 })
}
bench.sh
#!/bin/sh
# usage: ./bench.sh 200 500 1000   (requests per second, one 40 s step each)
set -eu
NET=$(docker compose ps -q proxy | xargs docker inspect --format '{{range $k, $v := .NetworkSettings.Networks}}{{$k}}{{end}}')
for RATE in "$@"; do
  echo "=== ${RATE} req/s"
  # mid-run snapshot of container CPU / memory and host CPU steal ("st") and swap ("si so")
  ( sleep 20; docker stats --no-stream --format '{{.Name}} cpu={{.CPUPerc}} mem={{.MemUsage}}' $(docker compose ps -q); vmstat 5 2 | tail -1 ) &
  docker run --rm -i --network "$NET" -e RATE="$RATE" -e DURATION=40s \
    grafana/k6 run --quiet - < k6.js 2>&1 | grep -E 'http_req_duration\.|http_req_failed\.|http_reqs|dropped_iterations|vus_max'
  wait
done
sh make-env.sh
docker compose up -d --build
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < init.sql
docker compose exec -T db sh -c 'psql -v ON_ERROR_STOP=1 -q -U $POSTGRES_USER -d $POSTGRES_DB' < seed.sql
curl -s http://127.0.0.1:8080/readyz
./bench.sh 500 1000
docker compose down -v
Tus cifras serán distintas. Cuando lo sean, confía en ellas antes que en las nuestras, y después configura un servidor cloud para tu aplicación o escribe a sales@dcxv.com.